Tips Mengoptimalkan GPU untuk AI Lokal, Cara Mempercepat Inferensi dan Menekan Beban Sistem
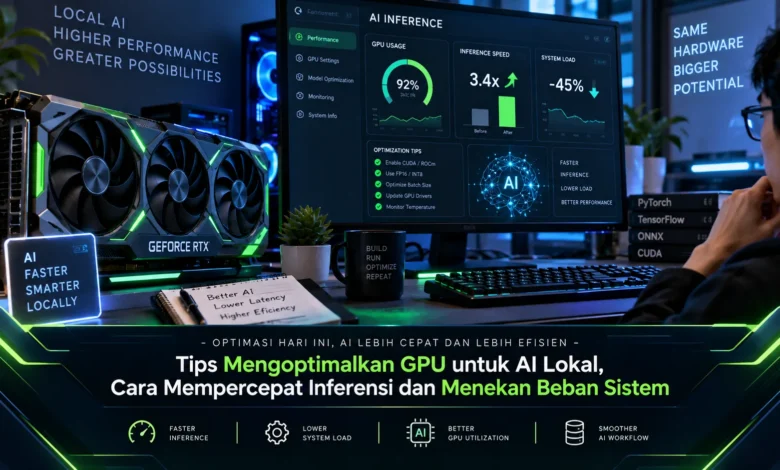
Menjalankan AI secara lokal semakin menarik karena pengguna dapat memproses model langsung melalui komputer sendiri tanpa selalu bergantung pada layanan cloud. Namun, performa AI lokal sangat dipengaruhi oleh kemampuan GPU, kapasitas VRAM, ukuran model, serta konfigurasi software yang digunakan. Dengan optimasi yang tepat, inferensi dapat berjalan lebih cepat sekaligus menjaga beban sistem tetap terkendali. Pendekatan ini semakin relevan dalam perkembangan TEKNOLOGI AI ketika model lokal mulai digunakan untuk berbagai kebutuhan produktivitas dan eksperimen.
Sesuaikan Model AI dengan Kemampuan GPU yang Tersedia
Langkah awal dalam mengoptimalkan GPU untuk AI lokal ialah mengetahui kebutuhan komputasi dari model yang digunakan. Setiap arsitektur kecerdasan buatan memiliki karakter penggunaan GPU yang berbeda, sehingga model berukuran besar belum tentu menjadi pilihan paling efisien. Model yang seimbang dengan kemampuan GPU dapat membantu menghasilkan performa yang lebih nyaman untuk penggunaan sehari hari.
Pengguna sebaiknya memperhatikan kapasitas VRAM yang tersedia sebab model dan berbagai proses komputasi menggunakan memory secara bersamaan. Ketika model menghabiskan hampir semua VRAM, workload dapat mengalami tekanan memory saat konteks maupun data bertambah. Dengan menyesuaikan model terhadap hardware yang dimiliki, inferensi lokal dapat berjalan dengan penggunaan sumber daya yang lebih terkendali.
Manajemen Memory Menjadi Kunci Performa AI Lokal
Memory GPU menjadi salah satu komponen utama dalam proses inferensi model secara lokal. Ketika model berhasil dimuat sepenuhnya pada GPU, inferensi biasanya dapat berjalan lebih efisien dibandingkan konfigurasi yang sering melakukan pertukaran data antara VRAM dan memory utama.
Menghentikan software yang mengonsumsi memory grafis secara tidak penting dapat membantu menyediakan lebih banyak VRAM untuk AI. Aplikasi visual, software editing, browser, serta program lain yang memanfaatkan GPU mungkin mengambil kapasitas memory yang sebenarnya dapat digunakan model. Memberikan ruang memory cadangan juga dapat membantu sistem menghadapi perubahan kebutuhan memory. Pendekatan pengelolaan memory ini menjadi salah satu cara praktis mengoptimalkan TEKNOLOGI AI lokal dengan perangkat yang sudah tersedia.
Quantization Membantu Model Besar Berjalan Lebih Ringan
Quantization menjadi salah satu teknik yang banyak digunakan untuk membuat inferensi lokal menjadi lebih ringan. Metode tersebut menyimpan parameter menggunakan format numerik yang lebih ringkas, sehingga model dapat membutuhkan kapasitas memory yang lebih kecil. Representasi bobot yang lebih ringkas dapat membuat model berukuran besar lebih mudah dijalankan pada GPU konsumen.
Konfigurasi quantization perlu mempertimbangkan keseimbangan antara kualitas dan efisiensi. Quantization yang lebih agresif dapat membuat ukuran model semakin kecil, meski akurasi maupun konsistensi keluaran dapat berubah tergantung model. Dengan demikian, pengguna sebaiknya membandingkan beberapa konfigurasi untuk menemukan titik seimbang antara kecepatan, kualitas, dan penggunaan memory.
Atur Context dan Batch Size agar GPU Tidak Terbebani
Di samping parameter model, ukuran konteks memiliki pengaruh terhadap konsumsi sumber daya. Konteks dengan jumlah token lebih besar berpotensi meningkatkan kebutuhan memory untuk mempertahankan informasi pemrosesan. Ketika tugas tidak memerlukan riwayat yang terlalu luas, menyesuaikan panjang konteks dapat membantu menjaga konsumsi memory.
Jumlah data yang diproses secara bersamaan turut memengaruhi performa. Batch yang terlalu besar berpotensi membuat VRAM menjadi penuh, sedangkan ukuran yang sangat rendah dapat mengurangi efisiensi pemrosesan. Penyesuaian batch sebaiknya dilakukan sedikit demi sedikit dengan memperhatikan perubahan konsumsi memory serta throughput. Metode penyesuaian bertahap tersebut membuat optimalisasi TEKNOLOGI AI menjadi lebih terukur.
Atur Pembagian Workload agar GPU Bekerja Lebih Efektif
Kecepatan inferensi bukan hanya bergantung pada spesifikasi kartu grafis. Framework, backend komputasi, driver, serta konfigurasi software berpotensi memengaruhi kecepatan dan penggunaan sumber daya. Framework yang telah dioptimalkan untuk hardware yang digunakan dapat mengurangi overhead dan mempercepat proses inferensi.
Pengguna dapat menentukan seberapa banyak bagian model yang diproses melalui kartu grafis. Jika VRAM mencukupi, bagian model yang diakselerasi kartu grafis dapat diperbesar untuk mengurangi ketergantungan terhadap CPU. Jika VRAM terbatas, porsi tertentu dapat diproses melalui memory sistem dan prosesor, meski respons model mungkin menjadi lebih lambat. Menemukan pembagian yang tepat menjadi langkah penting untuk mengoptimalkan TEKNOLOGI AI lokal.
Monitoring GPU Membantu Menjaga Performa AI Lokal
Penyesuaian konfigurasi sebaiknya didasarkan pada hasil monitoring. Beban GPU, kapasitas VRAM, aktivitas CPU, penggunaan RAM, temperatur perangkat, serta respons model dapat digunakan untuk mengetahui kondisi sistem saat AI aktif. Hasil pengamatan ini membantu menunjukkan bagian mana yang menjadi bottleneck.
Ketika aktivitas GPU rendah sedangkan penggunaan CPU mendekati batas, pembagian komputasi mungkin belum memanfaatkan GPU secara optimal. Apabila memory GPU terus berada pada kapasitas maksimum, quantization, context, cache, maupun ukuran model dapat dievaluasi. Temperatur yang terlalu tinggi dalam waktu lama berpotensi membuat kecepatan tidak stabil. Dengan mengidentifikasi hambatan secara akurat, pengguna tidak perlu langsung mengganti hardware ketika masalah masih dapat diperbaiki melalui konfigurasi.
Optimasi GPU Membuat AI Lokal Lebih Cepat dan Efisien
Mengoptimalkan GPU untuk AI lokal membutuhkan keseimbangan antara ukuran model, kapasitas VRAM, konfigurasi inferensi, dan kemampuan sistem. Pemilihan model realistis, manajemen VRAM, precision yang efisien, konfigurasi context, batch, serta pembagian workload berpotensi memberikan respons lebih cepat tanpa membebani perangkat secara berlebihan.
Evaluasi kondisi hardware perlu menjadi bagian dari proses optimasi karena kombinasi GPU, CPU, RAM, model, dan software tidak selalu sama. Perkembangan TEKNOLOGI AI lokal yang semakin cepat membuat optimasi sumber daya semakin relevan bagi pengguna. Melalui eksperimen terukur terhadap model dan pengaturan sistem, kombinasi performa serta efisiensi yang ideal dapat ditemukan tanpa sekadar menebak. Pembaca dapat mencoba setiap langkah secara bertahap untuk mengetahui optimasi mana yang memberikan peningkatan terbesar.