Tips Menjalankan LLM Offline untuk Pemula, Cara Memilih Model AI Sesuai Kemampuan Laptop dan PC
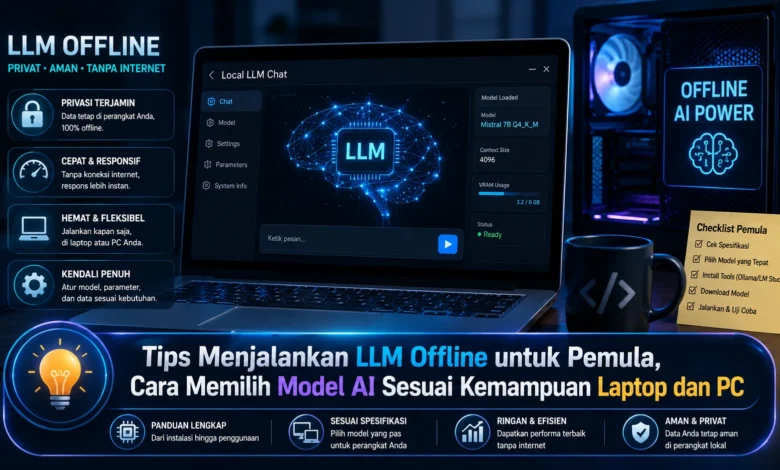
Menjalankan Large Language Model atau LLM langsung di laptop maupun PC kini semakin mudah dilakukan tanpa harus selalu mengandalkan layanan AI berbasis cloud. Bagi pemula, tantangan utamanya bukan sekadar memasang aplikasi, melainkan memilih model yang sesuai dengan kemampuan RAM, GPU, VRAM, prosesor, dan penyimpanan perangkat. Dengan memahami kebutuhan hardware dan karakter setiap model, TEKNOLOGI AI lokal dapat digunakan untuk menulis, merangkum dokumen, membantu pemrograman, hingga berbagai eksperimen secara lebih privat dan fleksibel.
Periksa Spesifikasi Hardware Sebelum Menjalankan AI Lokal
Tahap awal sebelum memasang model bahasa di komputer adalah memahami kemampuan perangkat. RAM, kemampuan pemrosesan grafis, prosesor, serta disk yang tersedia akan menentukan konfigurasi LLM yang sesuai. Semakin besar model, biasanya semakin banyak sumber daya yang diperlukan.
Jika baru mulai mencoba, model berukuran besar belum tentu menjadi pilihan terbaik. Model yang lebih ringan sering lebih mudah dijalankan karena komputer tetap lebih responsif. Tujuan utamanya adalah kombinasi kemampuan model serta kecepatan, bukan hanya memilih model terbesar.



RAM dan VRAM Menjadi Faktor Penting dalam Menentukan Ukuran Model
Memori sistem serta memori grafis menjadi komponen utama ketika menentukan model AI offline. RAM digunakan untuk menampung model dan proses aplikasi, sementara VRAM berperan besar saat model diakselerasi kartu grafis. Ketika model terlalu berat, sistem dapat kesulitan menjalankan inferensi dengan nyaman.
Oleh sebab tersebut, pengguna sebaiknya tidak menggunakan seluruh kapasitas RAM untuk model. Komputer dengan kapasitas memori kecil dapat memilih model kompak terlebih dahulu. Perangkat dengan kapasitas hardware lebih tinggi memiliki fleksibilitas konfigurasi yang lebih tinggi. Cara tersebut membantu mengoptimalkan penggunaan TEKNOLOGI AI lokal.
Jumlah Parameter Bukan Satu Satunya Penentu Kualitas LLM
Jumlah parameter memang menjadi salah satu indikator kebutuhan komputasi, tetapi tidak dapat dijadikan patokan tunggal. Model yang lebih kecil tetapi modern dapat menawarkan kemampuan yang cukup kuat untuk kebutuhan sehari hari.
Ketika menentukan LLM, pertimbangkan jenis pekerjaan seperti menulis teks, coding, mengolah informasi panjang, atau percakapan umum. Model khusus pengembangan software, misalnya, dapat lebih sesuai untuk pekerjaan teknis dibandingkan model general purpose tertentu. Pendekatan berbasis kebutuhan membuat TEKNOLOGI AI tidak sekadar menghabiskan sumber daya.
Model Terkuantisasi Membantu LLM Berjalan pada Hardware Lebih Ringan
Quantization merupakan salah satu konsep penting bagi pengguna yang menginginkan inferensi lebih efisien. Dengan kuantisasi, representasi bobot model dapat dibuat lebih ringkas, sehingga kebutuhan RAM atau VRAM dapat menurun.
Meski demikian, tingkat kuantisasi tetap membutuhkan pertimbangan karena pengurangan presisi yang sangat tinggi dapat mengurangi kemampuan model dalam kondisi tertentu. Pada tahap awal, konfigurasi quantized yang tidak terlalu agresif biasanya lebih nyaman untuk dicoba. Ketika sudah terbiasa, pengguna dapat mencoba konfigurasi lain.
GPU Bukan Syarat Mutlak tetapi Bisa Membuat AI Lokal Lebih Responsif
Model bahasa di perangkat sendiri tidak selalu membutuhkan GPU khusus. Sejumlah TEKNOLOGI AI lokal memungkinkan pemrosesan menggunakan CPU. Cara tersebut dapat membuka akses AI lokal bagi lebih banyak perangkat, meskipun performa bergantung pada kemampuan prosesor.
Apabila perangkat memiliki kartu grafis yang kompatibel, sebagian komputasi AI dapat diakselerasi menggunakan kartu grafis. Dengan konfigurasi yang tepat, respons dapat diproses dengan performa lebih tinggi. Namun, memori GPU masih menjadi batas penting, sehingga GPU yang tersedia tidak otomatis cocok untuk semua LLM.
Pilih Runtime Lokal yang Mudah Digunakan dan Sesuai Workflow
Setelah mengetahui kemampuan hardware, langkah berikutnya adalah menentukan aplikasi inferensi. Runtime tersebut berfungsi untuk mengelola proses inferensi serta menghubungkan model dengan aplikasi. Pada tahap belajar, aplikasi dengan antarmuka yang mudah dipahami dapat mengurangi kesulitan teknis.
Pemula yang belum terbiasa dengan terminal dapat menggunakan runtime dengan antarmuka grafis. Sementara itu, mereka yang membutuhkan otomatisasi dapat memilih runtime berbasis command line agar lebih mudah diintegrasikan. Runtime yang paling sesuai bukan selalu TEKNOLOGI dengan konfigurasi paling luas, melainkan yang membuat LLM mudah dikelola.
Pengaturan Inferensi Membantu AI Lokal Berjalan Lebih Stabil
Ukuran model bukan satu satunya faktor dalam mengoptimalkan LLM offline. Panjang konteks juga dapat berpengaruh terhadap penggunaan sumber daya. Ketika jumlah token konteks bertambah, sistem dapat mengalami peningkatan beban inferensi.
Bagi pemula, gunakan context window sesuai kebutuhan dan kurangi program lain yang menghabiskan RAM. Perhatikan pula beban sistem, kapasitas grafis, serta temperatur perangkat. Jika sistem terasa terlalu berat, gunakan kuantisasi lebih ringan hingga diperoleh keseimbangan yang nyaman.
Kesimpulan, Memilih LLM Sesuai Hardware Membuat AI Lokal Lebih Nyaman
Mengoperasikan model bahasa di perangkat sendiri tidak harus dimulai dengan hardware kelas atas. Kunci utamanya adalah memahami kemampuan laptop atau PC, kemudian menentukan LLM secara realistis. Sumber daya perangkat, format model, serta runtime dan context window bersama sama menentukan kenyamanan penggunaan.
Bagi pemula, pilih LLM yang tidak terlalu membebani perangkat, kemudian tingkatkan secara bertahap. Bagaimana menurut Anda, apakah LLM offline akan berkembang menjadi alternatif penting seiring hardware konsumen semakin kuat? Bagikan pandangan Anda mengenai penggunaan LLM lokal dan terus pantau perkembangan terbaru untuk mengetahui cara mengoptimalkan LLM.