Tips Menjalankan LLM Offline untuk Pemula, Cara Memilih Model AI Sesuai Kemampuan Laptop dan PC
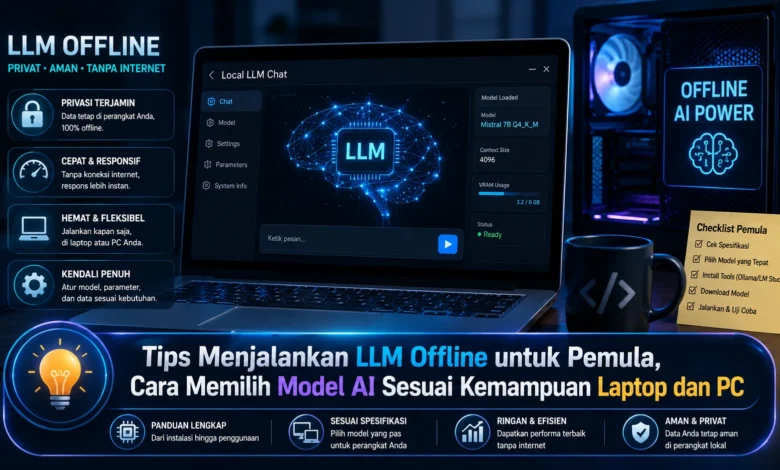
Menjalankan Large Language Model atau LLM langsung di laptop maupun PC kini semakin mudah dilakukan tanpa harus selalu mengandalkan layanan AI berbasis cloud. Bagi pemula, tantangan utamanya bukan sekadar memasang aplikasi, melainkan memilih model yang sesuai dengan kemampuan RAM, GPU, VRAM, prosesor, dan penyimpanan perangkat. Dengan memahami kebutuhan hardware dan karakter setiap model, TEKNOLOGI AI lokal dapat digunakan untuk menulis, merangkum dokumen, membantu pemrograman, hingga berbagai eksperimen secara lebih privat dan fleksibel.
Memahami Kemampuan Perangkat Menjadi Langkah Awal Menjalankan LLM Offline
Tahap awal sebelum menggunakan AI lokal adalah mengetahui kapasitas hardware yang tersedia. Memori sistem, kartu grafis serta memori video, CPU, serta ruang penyimpanan akan memengaruhi ukuran model yang nyaman dijalankan. Semakin kompleks model yang digunakan, biasanya beban perangkat menjadi lebih tinggi.
Bagi pemula, model berukuran besar belum tentu menjadi pilihan terbaik. Model yang lebih ringan sering lebih mudah dijalankan karena waktu respons dapat lebih cepat. Target yang ideal adalah keseimbangan antara kualitas dan performa, bukan sekadar mengejar jumlah parameter.
RAM dan VRAM Menjadi Faktor Penting dalam Menentukan Ukuran Model
Kapasitas memori komputer menjadi komponen utama ketika menyiapkan inferensi di perangkat sendiri. Memori sistem dapat digunakan untuk mendukung pemuatan data model, sementara VRAM membantu GPU menangani bagian model. Apabila kebutuhan model melebihi kapasitas, sistem dapat mengalami penurunan responsivitas.
Karena itu, pengguna sebaiknya menyisakan ruang memori untuk sistem operasi. Komputer dengan kapasitas memori kecil dapat memulai menggunakan model kecil yang sudah dikuantisasi. Komputer yang memiliki sumber daya lebih luas memiliki pilihan model yang lebih banyak. Cara tersebut membantu mengurangi percobaan yang terlalu berat.
Jumlah Parameter Bukan Satu Satunya Penentu Kualitas LLM
Ukuran sebuah model memang memberikan gambaran mengenai kompleksitas model, tetapi bukan satu satunya ukuran kualitas. LLM kompak dengan arsitektur yang baik dapat menawarkan kemampuan yang cukup kuat untuk penggunaan yang lebih spesifik.
Saat memilih model, pertimbangkan jenis pekerjaan seperti menulis teks, pengembangan perangkat lunak, merangkum dokumen, atau percakapan umum. LLM yang dioptimalkan bagi pemrograman, misalnya, dapat memberikan hasil lebih relevan pada kode dibandingkan model general purpose tertentu. Pendekatan berbasis kebutuhan membuat TEKNOLOGI AI memberikan manfaat lebih tepat.
Gunakan Quantized Model untuk Mengurangi Kebutuhan Memori
Quantization merupakan salah satu konsep penting bagi pengguna yang memiliki hardware terbatas. Dengan kuantisasi, representasi bobot model dapat disimpan dengan presisi lebih rendah, sehingga model lebih mudah dimuat pada perangkat konsumen.
Walaupun menawarkan efisiensi, tingkat kuantisasi sebaiknya disesuaikan dengan kebutuhan karena konfigurasi yang terlalu ringan dapat membawa kompromi terhadap hasil. Bagi pengguna baru, model terkuantisasi dengan keseimbangan kualitas dan ukuran biasanya dapat memberikan pengalaman yang seimbang. Sesudah mengetahui kemampuan perangkat, pengguna dapat membandingkan tingkat kuantisasi.
CPU Tetap Bisa Menjalankan LLM tetapi GPU Membantu Mempercepat Inferensi
LLM lokal tidak selalu membutuhkan GPU khusus. Berbagai aplikasi inferensi memungkinkan model dijalankan melalui prosesor utama. Cara tersebut dapat digunakan pada komputer tanpa kartu grafis bertenaga, meskipun performa bergantung pada kemampuan prosesor.
Apabila perangkat memiliki kartu grafis yang kompatibel, sebagian komputasi AI dapat ditangani melalui pemrosesan paralel. Dengan konfigurasi yang tepat, respons dapat diproses dengan performa lebih tinggi. Namun, memori GPU masih menjadi batas penting, sehingga GPU yang tersedia tidak otomatis cocok untuk semua LLM.
Runtime AI Lokal Menyederhanakan Proses Memasang dan Menjalankan Model
Setelah mengetahui kemampuan hardware, langkah berikutnya adalah menggunakan perangkat lunak pengelola LLM. Aplikasi AI lokal berfungsi untuk memuat model serta menghubungkan model dengan aplikasi. Untuk pengguna baru, aplikasi dengan antarmuka yang mudah dipahami dapat mempercepat proses belajar.
Pemula yang belum terbiasa dengan terminal dapat mencari software dengan pengelolaan model visual. Sementara itu, pengguna teknis dapat mengoperasikan model melalui terminal agar lebih mudah diintegrasikan. Pilihan terbaik bukan selalu TEKNOLOGI dengan konfigurasi paling luas, melainkan yang sesuai kebutuhan pengguna.
Pengaturan Inferensi Membantu AI Lokal Berjalan Lebih Stabil
Spesifikasi model bukan satu satunya penentu dalam mengoptimalkan LLM offline. Panjang konteks juga dapat berpengaruh terhadap penggunaan sumber daya. Ketika jumlah token konteks bertambah, sistem dapat membutuhkan memori tambahan.
Untuk penggunaan sehari hari, gunakan jumlah token yang realistis dan sisakan sumber daya untuk runtime AI. Perhatikan pula penggunaan RAM, memori GPU, serta suhu CPU dan GPU. Jika sistem terasa terlalu berat, gunakan kuantisasi lebih ringan hingga TEKNOLOGI AI dapat digunakan tanpa membebani perangkat secara berlebihan.
Kesimpulan, Pemula Sebaiknya Memulai LLM Offline dari Model yang Sesuai Perangkat
Menjalankan LLM offline tidak harus dimulai dengan hardware kelas atas. Hal yang lebih penting adalah mengenali batas sumber daya perangkat, kemudian menggunakan model berdasarkan kebutuhan. Kapasitas memori, format model, serta pengaturan inferensi bersama sama menentukan kenyamanan penggunaan.
Untuk pengguna yang baru mencoba, mulailah dengan model yang ringan, kemudian lakukan eksperimen sesuai kemampuan hardware. Dari pengalaman Anda, apakah AI lokal akan menjadi semakin populer seiring hardware konsumen semakin kuat? Sampaikan pengalaman Anda mengenai perkembangan AI offline dan ikuti pembahasan berikutnya untuk mengetahui cara mengoptimalkan LLM.