Tips Mengoptimalkan GPU untuk AI Lokal, Cara Mempercepat Inferensi dan Menekan Beban Sistem
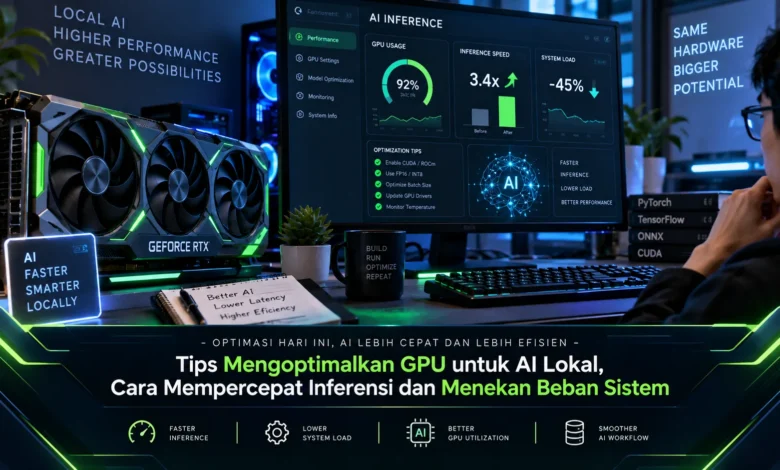
Menjalankan AI secara lokal semakin menarik karena pengguna dapat memproses model langsung melalui komputer sendiri tanpa selalu bergantung pada layanan cloud. Namun, performa AI lokal sangat dipengaruhi oleh kemampuan GPU, kapasitas VRAM, ukuran model, serta konfigurasi software yang digunakan. Dengan optimasi yang tepat, inferensi dapat berjalan lebih cepat sekaligus menjaga beban sistem tetap terkendali. Pendekatan ini semakin relevan dalam perkembangan TEKNOLOGI AI ketika model lokal mulai digunakan untuk berbagai kebutuhan produktivitas dan eksperimen.
Pahami Beban Model agar Inferensi Lokal Lebih Efisien
Hal utama sebelum melakukan optimasi GPU dimulai dengan mengenali ukuran serta kebutuhan sumber daya model. Setiap arsitektur kecerdasan buatan memiliki karakter penggunaan GPU yang berbeda, karena model dengan parameter lebih banyak tidak selalu ideal untuk perangkat lokal. Arsitektur yang cocok dengan spesifikasi hardware biasanya dapat memberikan inferensi yang lebih stabil.
Kapasitas memory GPU perlu diperiksa sebelum model dimuat karena bobot model serta data sementara harus berada di memory ketika diproses. Ketika model menghabiskan hampir semua VRAM, performa dapat menjadi kurang stabil ketika proses lain membutuhkan memory. Melalui pemilihan model berdasarkan kemampuan perangkat, pengguna dapat memperoleh keseimbangan yang lebih baik antara kualitas model dan performa sistem.



Atur Penggunaan VRAM untuk Mengurangi Beban Sistem
VRAM merupakan salah satu sumber daya paling penting ketika menjalankan AI lokal. Ketika model berhasil dimuat sepenuhnya pada GPU, pemrosesan berpotensi berlangsung lebih cepat dibandingkan konfigurasi yang sering melakukan pertukaran data antara VRAM dan memory utama.
Menutup aplikasi yang tidak diperlukan bisa memberikan ruang memory tambahan bagi model. Program grafis, browser dengan banyak proses, permainan, dan aplikasi video dapat menggunakan sebagian VRAM meskipun bukan bagian dari workload AI. Tidak menggunakan seluruh kapasitas VRAM sejak awal membantu menjaga stabilitas saat workload membutuhkan alokasi tambahan. Pendekatan pengelolaan memory ini menjadi salah satu cara praktis mengoptimalkan TEKNOLOGI AI lokal dengan perangkat yang sudah tersedia.
Quantization Membantu Model Besar Berjalan Lebih Ringan
Pengurangan precision model merupakan strategi yang cukup efektif ketika ingin menekan kebutuhan sumber daya model. Quantization mengurangi jumlah bit yang diperlukan untuk menyimpan sebagian informasi model, yang membuat konsumsi VRAM berpotensi menjadi lebih rendah. Representasi bobot yang lebih ringkas dapat membantu pengguna menjalankan model lokal menggunakan sumber daya yang lebih realistis.
Konfigurasi quantization perlu mempertimbangkan keseimbangan antara kualitas dan efisiensi. Quantization yang lebih agresif dapat membuat ukuran model semakin kecil, meski akurasi maupun konsistensi keluaran dapat berubah tergantung model. Oleh sebab itu, pengguna sebaiknya membandingkan beberapa konfigurasi agar diperoleh kombinasi performa dan kualitas yang sesuai.
Sesuaikan Beban Inferensi dengan Kapasitas Perangkat
Di samping parameter model, panjang context juga dapat memengaruhi kebutuhan memory selama inferensi. Riwayat percakapan yang semakin luas dapat membuat penggunaan VRAM bertambah seiring meningkatnya data yang harus dipertahankan. Apabila workload hanya membutuhkan percakapan atau dokumen berukuran sedang, menggunakan batas context yang lebih realistis dapat mengurangi beban sistem.
Jumlah data yang diproses secara bersamaan turut memengaruhi performa. Ukuran batch yang berlebihan dapat memberikan tekanan besar pada kapasitas GPU, sedangkan ukuran yang sangat rendah dapat mengurangi efisiensi pemrosesan. Penyesuaian batch sebaiknya dilakukan sedikit demi sedikit dengan memperhatikan perubahan konsumsi memory serta throughput. Pendekatan berbasis pengujian lebih efektif untuk menemukan konfigurasi optimal.
Framework yang Tepat Bisa Meningkatkan Performa AI Lokal
Kecepatan inferensi bukan hanya bergantung pada spesifikasi kartu grafis. Framework, backend komputasi, driver, serta konfigurasi software berpotensi memengaruhi kecepatan dan penggunaan sumber daya. Runtime yang mendukung kemampuan komputasi perangkat secara tepat dapat mengurangi overhead dan mempercepat proses inferensi.
GPU offloading juga dapat disesuaikan dengan kapasitas perangkat. Apabila kapasitas memory GPU masih tersedia, lebih banyak komponen model dapat ditempatkan pada GPU sehingga sebagian besar komputasi berat dapat ditangani GPU. Jika VRAM terbatas, porsi tertentu dapat diproses melalui memory sistem dan prosesor, meskipun kecepatan inferensi dapat menurun. Menemukan pembagian yang tepat menjadi langkah penting untuk mengoptimalkan TEKNOLOGI AI lokal.
Identifikasi Hambatan Sistem Sebelum Mengubah Hardware
Penyesuaian konfigurasi sebaiknya didasarkan pada hasil monitoring. Beban GPU, kapasitas VRAM, aktivitas CPU, penggunaan RAM, temperatur perangkat, serta respons model dapat digunakan untuk mengetahui kondisi sistem saat AI aktif. Informasi tersebut membantu pengguna menentukan komponen yang membatasi kecepatan.
Ketika aktivitas GPU rendah sedangkan penggunaan CPU mendekati batas, pembagian komputasi mungkin belum memanfaatkan GPU secara optimal. Ketika konsumsi VRAM sangat tinggi, konfigurasi model dan kebutuhan memory sebaiknya ditinjau kembali. Temperatur yang terlalu tinggi dalam waktu lama juga dapat memengaruhi konsistensi performa. Melalui monitoring sebelum melakukan perubahan, penyesuaian dapat difokuskan pada sumber masalah sebenarnya.
Optimasi GPU Membuat AI Lokal Lebih Cepat dan Efisien
Mengoptimalkan GPU untuk AI lokal membutuhkan keseimbangan antara ukuran model, kapasitas VRAM, konfigurasi inferensi, dan kemampuan sistem. Pemilihan model realistis, manajemen VRAM, precision yang efisien, konfigurasi context, batch, serta pembagian workload berpotensi memberikan respons lebih cepat tanpa membebani perangkat secara berlebihan.
Pemantauan performa sebaiknya tetap dilakukan setelah setiap perubahan karena setiap perangkat memiliki karakteristik yang berbeda. Pertumbuhan TEKNOLOGI model lokal menjadikan efisiensi hardware sebagai faktor yang semakin penting. Melalui eksperimen terukur terhadap model dan pengaturan sistem, pengguna dapat menemukan konfigurasi AI lokal yang cepat, stabil, dan sesuai kebutuhan. Pembaca dapat membandingkan beberapa pengaturan untuk menemukan kombinasi terbaik bagi workload AI lokal masing masing.