Tips Mengoptimalkan GPU untuk AI Lokal, Cara Mempercepat Inferensi dan Menekan Beban Sistem
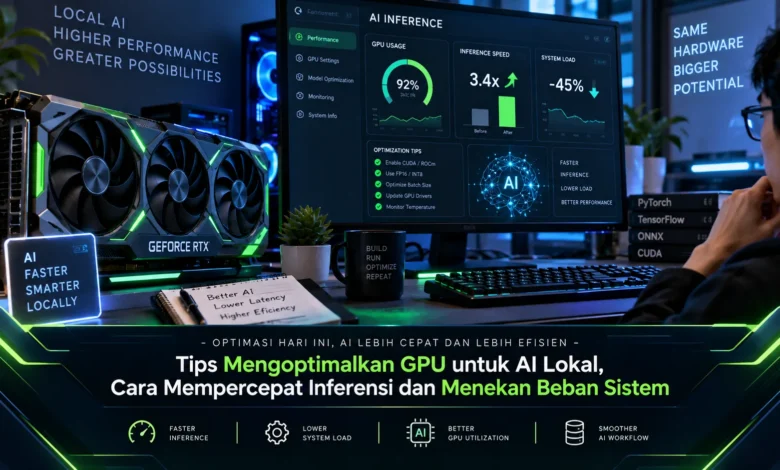
Menjalankan AI secara lokal semakin menarik karena pengguna dapat memproses model langsung melalui komputer sendiri tanpa selalu bergantung pada layanan cloud. Namun, performa AI lokal sangat dipengaruhi oleh kemampuan GPU, kapasitas VRAM, ukuran model, serta konfigurasi software yang digunakan. Dengan optimasi yang tepat, inferensi dapat berjalan lebih cepat sekaligus menjaga beban sistem tetap terkendali. Pendekatan ini semakin relevan dalam perkembangan TEKNOLOGI AI ketika model lokal mulai digunakan untuk berbagai kebutuhan produktivitas dan eksperimen.
Pahami Beban Model agar Inferensi Lokal Lebih Efisien
Hal utama sebelum melakukan optimasi GPU adalah memahami karakteristik model yang akan dijalankan. Setiap model memiliki kebutuhan VRAM dan komputasi yang berbeda, sehingga memilih model terbesar belum tentu memberikan pengalaman penggunaan terbaik. Model yang sesuai dengan kapasitas perangkat biasanya dapat memberikan inferensi yang lebih stabil.
Kapasitas memory GPU perlu diperiksa sebelum model dimuat karena bobot model serta data sementara harus berada di memory ketika diproses. Jika penggunaan VRAM terlalu mendekati kapasitas maksimum, performa dapat menjadi kurang stabil ketika proses lain membutuhkan memory. Dengan menyesuaikan model terhadap hardware yang dimiliki, pengguna dapat membangun konfigurasi TEKNOLOGI AI lokal yang lebih efisien.
Manajemen Memory Menjadi Kunci Performa AI Lokal
VRAM merupakan salah satu sumber daya paling penting dalam proses inferensi model secara lokal. Ketika model berhasil dimuat sepenuhnya pada GPU, respons model cenderung menjadi lebih optimal dibandingkan konfigurasi yang sering melakukan pertukaran data antara VRAM dan memory utama.
Menutup aplikasi yang tidak diperlukan dapat membuat kapasitas GPU yang tersedia menjadi lebih besar. Program grafis, browser dengan banyak proses, permainan, dan aplikasi video berpotensi mengurangi ruang yang tersedia untuk proses inferensi. Menjaga sebagian VRAM tetap tersedia dapat memberikan fleksibilitas ketika ukuran konteks meningkat. Manajemen seperti ini bisa meningkatkan kenyamanan penggunaan tanpa membutuhkan GPU baru.
Gunakan Quantization untuk Menekan Konsumsi VRAM
Quantization menjadi salah satu teknik yang banyak digunakan untuk menjalankan model AI secara lokal. Metode tersebut menyimpan parameter menggunakan format numerik yang lebih ringkas, sehingga kebutuhan memory dapat turun secara signifikan. Representasi bobot yang lebih ringkas dapat membantu pengguna menjalankan model lokal menggunakan sumber daya yang lebih realistis.
Pemilihan tingkat quantization tetap perlu disesuaikan dengan kebutuhan. Precision yang semakin rendah dapat menghemat memory lebih banyak, namun hasil inferensi tertentu mungkin mengalami penurunan kualitas. Karena itu, pengujian pada workload nyata menjadi langkah yang penting untuk menemukan titik seimbang antara kecepatan, kualitas, dan penggunaan memory.
Konfigurasi Batch dan Context Membantu Menjaga Efisiensi
Di samping parameter model, panjang context juga dapat memengaruhi kebutuhan memory selama inferensi. Riwayat percakapan yang semakin luas dapat membutuhkan kapasitas tambahan untuk menyimpan cache selama proses generasi. Jika kebutuhan penggunaan tidak memerlukan konteks sangat panjang, menggunakan batas context yang lebih realistis dapat mengurangi beban sistem.
Ukuran batch merupakan konfigurasi lain yang perlu disesuaikan. Jumlah batch yang melampaui kemampuan perangkat berpotensi membuat VRAM menjadi penuh, sedangkan ukuran yang sangat rendah dapat mengurangi efisiensi pemrosesan. Ukuran batch dapat diuji dari konfigurasi rendah menuju lebih tinggi sembari membandingkan respons model dan utilisasi GPU. Metode penyesuaian bertahap tersebut dapat membantu menentukan pengaturan yang sesuai dengan perangkat.
Optimalkan Software dan GPU Offloading untuk Mempercepat Inferensi
Kemampuan hardware bukan satu satunya faktor yang menentukan performa model. Lingkungan software, backend pemrosesan, driver, serta konfigurasi inferensi dapat memberikan perbedaan performa yang cukup besar. Software yang mampu memanfaatkan akselerasi GPU secara baik dapat mengurangi overhead dan mempercepat proses inferensi.
Pembagian workload antara GPU dan CPU dapat diatur berdasarkan sumber daya yang tersedia. Jika VRAM mencukupi, bagian model yang diakselerasi kartu grafis dapat diperbesar untuk mengurangi ketergantungan terhadap CPU. Ketika model terlalu besar untuk dimuat sepenuhnya, pembagian komputasi dapat dilakukan antara GPU dengan sistem utama, meski respons model mungkin menjadi lebih lambat. Mengatur offloading secara seimbang dapat membantu memperoleh performa terbaik dari perangkat yang tersedia.
Pantau Suhu dan Utilisasi untuk Menemukan Bottleneck
Pengaturan performa akan lebih tepat jika menggunakan informasi penggunaan perangkat. Utilisasi GPU, konsumsi VRAM, penggunaan CPU, RAM, temperatur, serta kecepatan inferensi sebaiknya diperhatikan ketika model sedang melakukan inferensi. Hasil pengamatan ini dapat memperlihatkan sumber hambatan performa.
Ketika aktivitas GPU rendah sedangkan penggunaan CPU mendekati batas, konfigurasi offloading dapat menjadi salah satu bagian yang perlu diperiksa. Apabila memory GPU terus berada pada kapasitas maksimum, quantization, context, cache, maupun ukuran model dapat dievaluasi. Temperatur yang terlalu tinggi dalam waktu lama juga dapat memengaruhi konsistensi performa. Dengan mengidentifikasi hambatan secara akurat, pengguna dapat melakukan optimasi pada bagian yang benar.
Penutup
Optimalisasi AI lokal memerlukan penyesuaian antara kebutuhan model, memory GPU, software, serta spesifikasi perangkat. Pemilihan model yang sesuai, pengelolaan VRAM, quantization, pengaturan context, batch size, serta GPU offloading mampu meningkatkan efisiensi komputasi sambil menjaga penggunaan hardware tetap terkendali.
Pemantauan performa sebaiknya tetap dilakukan setelah setiap perubahan karena setiap perangkat memiliki karakteristik yang berbeda. Perkembangan TEKNOLOGI AI lokal yang semakin cepat mendorong pengguna untuk memanfaatkan kemampuan perangkat secara lebih cermat. Melalui eksperimen terukur terhadap model dan pengaturan sistem, kombinasi performa serta efisiensi yang ideal dapat ditemukan tanpa sekadar menebak. Pengguna dapat menguji konfigurasi satu per satu agar perubahan performa lebih mudah diukur.