DeepSeek Buka Kode DeepInfer untuk Mendukung Pemrosesan Model AI pada Berbagai Chip
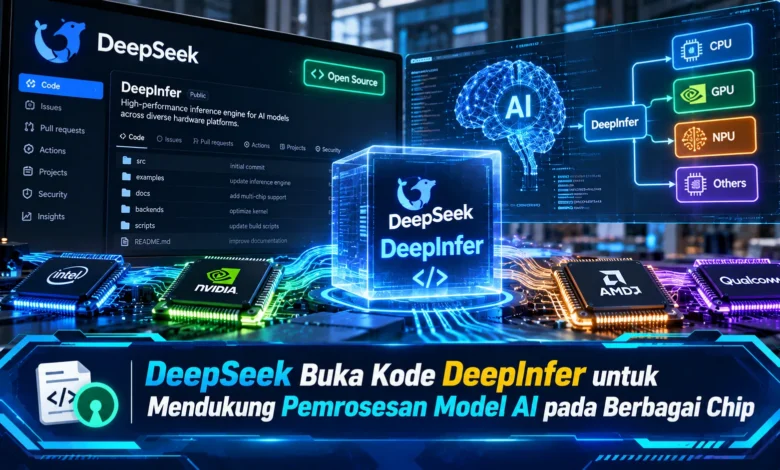
DeepSeek kembali menarik perhatian industri kecerdasan buatan setelah membuka kode sumber DeepInfer pada 20 Oktober 2026. Framework inferensi ini dirancang untuk membantu menjalankan model AI berskala besar dengan lebih efisien, terutama pada infrastruktur yang menggunakan jenis chip berbeda. Dalam rilis awalnya, DeepInfer mendukung GPU Nvidia berarsitektur SM100 serta NPU Huawei Ascend 950. Langkah tersebut memperlihatkan upaya DeepSeek memperluas pilihan perangkat keras tanpa mengabaikan kebutuhan performa dan efisiensi komputasi. Perkembangan TEKNOLOGI ini membuka peluang bagi pengembang dan perusahaan untuk mempelajari sistem inferensi yang digunakan dalam layanan DeepSeek, sekaligus memahami tantangan penerapannya pada pusat data modern.
Apa Itu DeepInfer dan Mengapa Penting bagi Pengembang AI?
Framework DeepInfer hadir sebagai sistem pemrosesan model kecerdasan buatan yang dirancang untuk mendukung pelayanan permintaan kecerdasan buatan dalam jumlah tinggi. Jika dibandingkan dengan proses pelatihan model yang membutuhkan pembaruan parameter, inferensi berfungsi memproses permintaan menggunakan kemampuan model yang tersedia. Ketika model melayani pengguna, sistem bertugas menangani permintaan dan memberikan jawaban dalam waktu yang sesuai. DeepInfer dirancang untuk meningkatkan efisiensi eksekusi model. Dengan pendekatan ini, DeepSeek membuka kesempatan mempelajari pengelolaan model skala besar.
Dirilisnya framework DeepInfer secara terbuka menunjukkan strategi pengembangan yang menarik dalam ekosistem perangkat lunak AI. Kode tersebut dapat diakses pada repositori resmi DeepSeek menggunakan lisensi Apache 2.0. Ketentuan sumber terbuka tersebut memungkinkan penggunaan dan modifikasi kode sesuai ketentuan Apache 2.0. Framework yang baru dirilis ini memanfaatkan pengalaman pengelolaan layanan AI DeepSeek untuk mendukung layanan kecerdasan buatan berskala produksi. Namun demikian, rilis publiknya tidak otomatis menyediakan semua kebutuhan operasional pusat data. Untuk memahami cakupan sebenarnya, pengembang perlu mempelajari fitur yang telah tersedia.


DeepInfer Mendukung GPU Nvidia dan NPU Huawei Ascend
Salah satu keunggulan utama adalah kompatibilitas dengan platform komputasi Nvidia dan Huawei. Berdasarkan dukungan perangkat keras yang diumumkan, DeepInfer mendukung GPU Nvidia SM100 dan NPU Huawei Ascend 950. Pilihan perangkat keras tersebut memberikan gambaran strategi penggunaan berbagai chip. Selama ini, variasi perangkat lunak pendukung chip menjadi salah satu tantangan penerapan. Melalui DeepInfer, DeepSeek mendukung pengembangan pada beberapa ekosistem komputasi. Meski demikian, penggunaan tetap terbatas pada perangkat yang didukung secara resmi.
Karakteristik masing-masing jenis chip membuat optimasi inferensi menjadi pekerjaan kompleks. Akselerator grafis Nvidia mengandalkan teknologi komputasi CUDA untuk menjalankan operasi pemrosesan paralel. Di sisi lain, Huawei Ascend menggunakan perangkat pengembangan CANN yang disesuaikan dengan arsitektur NPU Huawei. Variasi lingkungan pengembangan tersebut membutuhkan optimasi khusus pada setiap arsitektur. Dengan pertimbangan tersebut, kemampuan lintas chip tidak menghilangkan kebutuhan optimasi khusus. Pengembang tetap perlu menilai dukungan pustaka yang diperlukan sebelum menjalankan model pada produksi.
Bagaimana DeepInfer Mengelola Beban Kerja Model Bahasa Besar?
Framework ini mengintegrasikan berbagai teknologi percepatan model seperti FlashMLA, DeepGEMM, DeepEP, dan TileKernels. Berbagai pustaka tersebut membantu mengoptimalkan pekerjaan matematika model. Komponen pengolahan attention FlashMLA mendukung perhitungan attention secara efisien, sedangkan DeepGEMM mendukung optimasi perhitungan matematika model. DeepEP mendukung komunikasi pada sistem expert parallelism. Berkat integrasi pustaka khusus, framework dapat meningkatkan pemanfaatan akselerator. Namun demikian, peningkatan performa perlu dibuktikan melalui benchmark.
Sebagai pelengkap pemrosesan model, DeepInfer mendukung pemrosesan paralel melalui attention data parallelism, context parallelism, serta mixture-of-experts expert parallelism. Strategi pembagian komputasi tersebut membantu mengalokasikan bagian model pada beberapa akselerator. Pada arsitektur AI berbasis MoE, tidak semua bagian model harus aktif bersamaan. Framework ini turut mengintegrasikan mekanisme distribusi pekerjaan antar-expert agar pekerjaan tidak terkonsentrasi pada perangkat tertentu. Tidak kalah penting, sistem mengandalkan asynchronous scheduling untuk mengurangi jeda antara penjadwalan CPU dan eksekusi perangkat. Kombinasi kemampuan tersebut membantu meningkatkan efisiensi penggunaan chip.
Inovasi Pemrosesan Model DeepSeek-V4.1-Flash pada DeepInfer
Fitur penting lainnya DeepInfer adalah mekanisme pembangkitan token spekulatif. Metode tersebut membantu meningkatkan kecepatan pembangkitan token dengan memprediksi beberapa token terlebih dahulu. Pada sistem yang dikembangkan DeepSeek, digunakan teknologi DSpark bersama confidence-scheduled verification untuk mengatur proses pemeriksaan token berdasarkan tingkat keyakinan. Pendekatan tersebut membantu mempercepat keluaran model pada konfigurasi yang sesuai. Namun demikian, peningkatan kinerja dapat bervariasi. Untuk menilai keuntungan sebenarnya, pengembang perlu membandingkan hasil benchmark berdasarkan jenis permintaan pengguna.
Selain percepatan token, framework ini menghadirkan fitur structured outputs yang mendukung generasi keluaran mengikuti struktur tertentu. Dengan menggunakan fitur ini, model bisa menghasilkan keluaran sesuai grammar tertentu berdasarkan aturan yang disediakan pengembang. Fitur tersebut berguna dalam integrasi aplikasi yang membutuhkan data mudah diproses. Dalam penerapan praktis, aplikasi pengelolaan dokumen mampu mengolah respons yang mengikuti skema berisi kategori dokumen. Berkat pengendalian susunan respons, proses integrasi berpotensi menjadi lebih sederhana. Meski demikian, kebenaran isi tetap harus divalidasi sebelum diterapkan pada proses produksi.
Cara Memulai DeepInfer dan Batasan Rilis Sumber Terbuka
Pengembang yang ingin mencoba DeepInfer perlu menyiapkan lingkungan komputasi yang sesuai. Berdasarkan dokumentasi proyek, DeepInfer membutuhkan sistem operasi Linux, Python 3.12, serta GCC versi 13 atau lebih baru. Apabila menggunakan GPU Nvidia, lingkungan menggunakan perangkat lunak CUDA 13. Jika menggunakan akselerator Huawei, implementasi Ascend menggunakan lingkungan CANN versi 9.2. Ketika lingkungan sudah disiapkan, kode sumber dapat diperoleh dari repositori DeepSeek. Pada tahap kompilasi, jenis akselerator perlu ditentukan melalui variabel DEEPINFER_ACCELERATOR dengan nilai nvidia atau ascend. Tahapan pengaturan ini membantu menentukan jalur kompilasi yang digunakan.
Sesudah lingkungan pengembangan siap, pengguna dapat menjalankan contoh inferensi offline. Berdasarkan dukungan model yang diumumkan, DeepInfer difokuskan pada model DeepSeek-V4.1-Flash. Checkpoint model ini dapat dimuat dari sumber checkpoint yang kompatibel, dengan penggunaan memori yang perlu dievaluasi. Meski DeepInfer berasal dari sistem produksi, rilis sumber terbuka tidak mencakup keseluruhan komponen operasional produksi. Beberapa bagian penting mencakup manajemen cache konteks model, mekanisme disaggregated deployment secara lengkap, serta penyeimbangan beban pada replika data parallel. Karena itu, operator perlu membangun pengelolaan layanan tersendiri.
Dampak DeepInfer terhadap Industri Chip dan Infrastruktur AI
Hadirnya DeepInfer sebagai proyek sumber terbuka berpotensi memengaruhi perkembangan infrastruktur AI. Kemampuan menjalankan model melalui GPU maupun NPU tertentu memperlihatkan kebutuhan pilihan arsitektur yang lebih beragam. Selama ini, integrasi akselerator menjadi faktor penting dalam keputusan infrastruktur. Apabila kompatibilitas framework terus diperluas, perusahaan mungkin dapat membandingkan beberapa jenis chip. Walaupun manfaat potensialnya besar, hasil efisiensi harus diuji secara nyata. Faktor seperti latensi layanan, throughput sistem, efisiensi penggunaan energi, serta total biaya pengoperasian layanan.
Untuk komunitas pengembang AI, publikasi kode DeepInfer mendukung penelitian terhadap sistem pemrosesan terdistribusi. Pengembang dapat mempelajari implementasi kernel, menguji pengaruh pengaturan komputasi, serta membagikan hasil eksperimen kepada komunitas. Melalui ketentuan sumber terbuka tersebut, pemanfaatan kode dapat dilakukan sesuai lisensi. Walaupun kode tersedia secara terbuka, penerapan skala produksi tidak otomatis sederhana. Sistem AI dengan parameter sangat banyak dapat memerlukan banyak akselerator. Karena itu, organisasi harus menilai kesiapan infrastrukturnya sebelum memindahkan sistem penting ke framework baru.
Kesimpulan DeepInfer dan Masa Depan Pemrosesan AI
Peluncuran framework DeepInfer dari DeepSeek menjadi perkembangan penting dalam industri pemrosesan AI modern. Berkat integrasi GPU Nvidia SM100 dan NPU Huawei Ascend 950, DeepInfer membuka pilihan arsitektur komputasi yang lebih beragam. Integrasi optimasi kernel, paralelisme, speculative decoding, dan keluaran terstruktur berpotensi meningkatkan kemampuan pemrosesan model. Namun demikian, dukungan model masih terbatas. Karena kondisi tersebut, penerapan harus direncanakan secara realistis. Di tengah persaingan industri chip AI, DeepInfer mendorong pengembangan perangkat lunak AI yang lebih terbuka. Dari sudut pandang Anda, apakah framework multi-chip seperti DeepInfer akan membantu perusahaan memilih infrastruktur lebih efisien? Bagikan pendapat Anda mengenai pengembangan inferensi AI sumber terbuka.