AI Inference Engine Optimization Makin Penting saat AI Beralih dari Cloud ke Perangkat Lokal
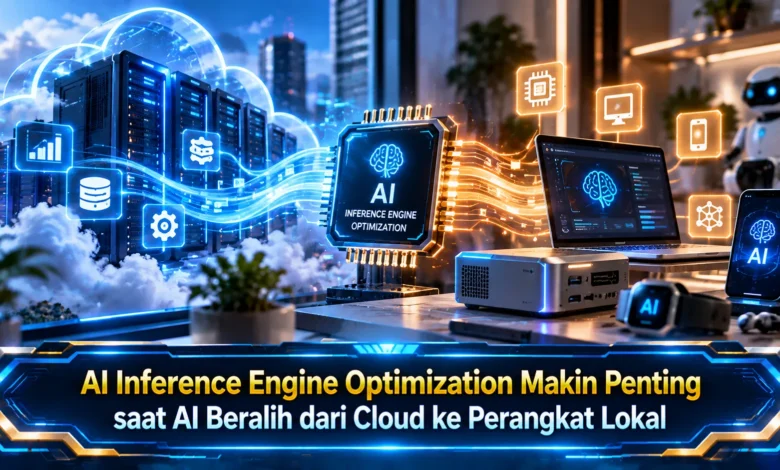
Perkembangan kecerdasan buatan mulai mendorong semakin banyak proses AI berjalan langsung pada smartphone, laptop, komputer, kendaraan, hingga perangkat edge tanpa selalu bergantung pada cloud. Perubahan ini membuat efisiensi inference menjadi semakin penting karena perangkat lokal memiliki batas daya, memori, temperatur, dan kemampuan komputasi. AI Inference Engine Optimization menjadi bagian penting dari perkembangan teknologi tersebut karena membantu model memanfaatkan CPU, GPU, NPU, memori, serta software secara lebih efisien agar pemrosesan AI lokal dapat berlangsung cepat dan responsif.
On Device AI Mengubah Cara Model Kecerdasan Buatan Dijalankan
Pada banyak implementasi kecerdasan buatan, proses komputasi sebelumnya banyak bergantung pada pusat data yang mempunyai kemampuan pemrosesan jauh lebih besar dibandingkan perangkat pengguna. Data input diteruskan menuju server tempat inference dilakukan lalu hasil pemrosesan dikirim kembali kepada pengguna. Cloud tetap memiliki peran penting untuk model berskala besar, tetapi perkembangan perangkat keras membuka peluang bagi berbagai fungsi AI untuk dijalankan secara lokal.
Peralihan menuju on device AI memberikan sejumlah keuntungan potensial seperti waktu respons lebih singkat, ketergantungan jaringan yang berkurang, serta kemampuan menjalankan fungsi tertentu tanpa koneksi internet terus menerus. Eksekusi lokal berpotensi mengurangi perpindahan informasi ke server apabila model dan aplikasi dapat menyelesaikan tugas langsung pada perangkat. Akan tetapi, manfaat tersebut diikuti tantangan karena teknologi AI lokal harus beroperasi dengan kapasitas yang lebih terbatas daripada server cloud.
Inference Engine Menentukan Efisiensi AI pada Perangkat Lokal
AI Inference Engine Optimization memiliki tujuan untuk cara menjalankan model yang telah dilatih secara lebih efisien ketika menerima input baru. Pada tahap inference, model menggunakan parameter yang telah diperoleh melalui proses pelatihan untuk menghasilkan prediksi, klasifikasi, teks, gambar, maupun keluaran lainnya. Semakin kompleks sebuah model, semakin besar pula potensi kebutuhan komputasi dan memori yang harus dikelola.
Efisiensi menjadi faktor utama pada on device AI karena kemampuan komputasi harus diseimbangkan dengan konsumsi daya perangkat. Smartphone memiliki batas baterai, laptop perlu mengontrol performa serta panas, sedangkan sistem edge sering bekerja dengan kapasitas memori dan daya yang terbatas. Oleh sebab itu, teknologi inference harus mengelola eksekusi model agar kemampuan perangkat dapat digunakan tanpa membebani sistem secara berlebihan.
NPU Semakin Penting untuk Menjalankan Beban Kerja AI
Smartphone dan laptop modern dapat menyediakan berbagai komponen pemrosesan untuk menangani tugas kecerdasan buatan. CPU memberikan kemampuan komputasi serbaguna, GPU menyediakan paralelisme besar, sedangkan NPU menghadirkan akselerasi yang diarahkan pada beban kerja AI. Kombinasi tersebut membuat perangkat memiliki beberapa pilihan untuk menentukan tempat sebuah operasi dijalankan.
Mesin inference membantu menentukan bagaimana beban kerja menggunakan unit komputasi yang terdapat di perangkat. Jenis komputasi tertentu dapat dialihkan menuju NPU, sedangkan operasi berbeda dapat dijalankan melalui GPU atau CPU sesuai kemampuan sistem. Pengelolaan yang tepat memungkinkan teknologi AI menggunakan accelerator sambil mengurangi overhead dan perpindahan informasi yang berlebihan.


Quantization Membuat Model AI Lebih Ringan untuk Perangkat Lokal
Quantization menjadi salah satu teknik yang dapat membantu mengurangi kebutuhan sumber daya ketika menjalankan model. Pendekatan ini menggunakan representasi angka dengan presisi yang lebih rendah untuk membantu menekan penggunaan memori dan beban pemrosesan. Pada perangkat lokal, pengurangan kebutuhan tersebut sangat penting karena kapasitas RAM, bandwidth memori, dan kemampuan pemrosesan tidak sebesar infrastruktur cloud.
Penerapan quantization perlu dievaluasi sebab penggunaan presisi yang terlalu rendah dapat memberikan dampak terhadap kualitas hasil. Konfigurasi yang tepat perlu mempertimbangkan ukuran model, performa inference, penggunaan memori, konsumsi energi, dan kualitas respons. Konfigurasi optimal dapat berbeda berdasarkan perangkat sehingga pengujian langsung pada hardware tujuan menjadi penting dalam teknologi AI.
On Device AI Membutuhkan Pengelolaan Memori yang Cermat
Performa AI lokal tidak semata mata ditentukan oleh kecepatan unit komputasi. Parameter dan informasi perlu dipindahkan antara memori dengan unit pemrosesan sehingga kemampuan bandwidth dapat memengaruhi performa. Apabila aliran data berjalan kurang efisien, unit pemrosesan yang kuat dapat mengalami waktu tunggu sebelum memperoleh informasi yang diperlukan.
Efisiensi energi juga menjadi bagian penting ketika AI dijalankan secara lokal. Pemrosesan AI dengan beban tinggi dalam waktu panjang dapat meningkatkan penggunaan daya dan panas. Oleh sebab itu, mesin inference dapat mengatur workload, memori, accelerator, serta jadwal komputasi untuk menyeimbangkan kecepatan dengan penggunaan daya. Keseimbangan tersebut menjadi semakin penting bagi teknologi AI yang diharapkan berjalan sepanjang hari pada perangkat pribadi.
Kesimpulan
AI Inference Engine Optimization menjadi semakin penting seiring lebih banyak fungsi kecerdasan buatan berpindah dari cloud menuju smartphone, laptop, dan perangkat edge. Perubahan tersebut menawarkan peluang untuk memperoleh respons lebih cepat, mengurangi ketergantungan terhadap koneksi cloud, serta menjalankan fungsi tertentu secara lokal. Namun, keterbatasan daya, memori, bandwidth, temperatur, dan kemampuan komputasi membuat model perlu dioptimalkan dengan cermat. Hardware seperti CPU, GPU, dan NPU perlu didukung quantization, manajemen memori, serta software inference agar teknologi AI memperoleh performa optimal. Dengan kemajuan optimalisasi perangkat keras dan perangkat lunak, teknologi AI lokal dapat berkembang menjadi lebih cepat, efisien, serta mampu menangani workload yang semakin kompleks. Pembaca juga dapat membagikan pendapat mengenai teknologi inference serta kemampuan AI lokal yang diharapkan hadir pada smartphone dan laptop generasi mendatang.