Tips Menjalankan LLM Offline untuk Pemula, Cara Memilih Model AI Sesuai Kemampuan Laptop dan PC
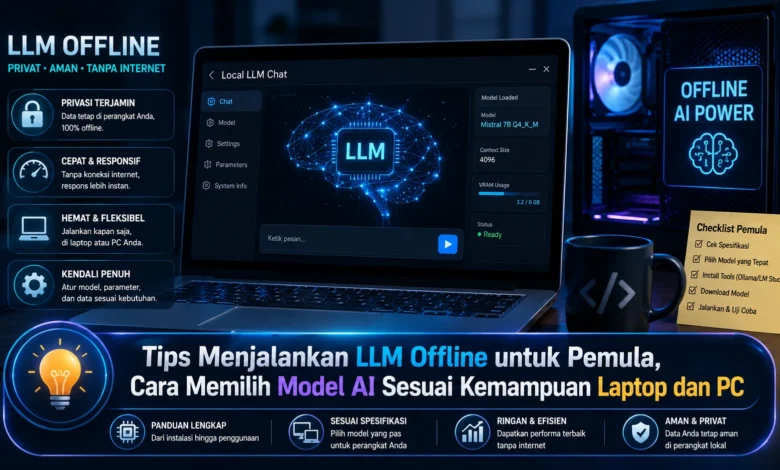
Menjalankan Large Language Model atau LLM langsung di laptop maupun PC kini semakin mudah dilakukan tanpa harus selalu mengandalkan layanan AI berbasis cloud. Bagi pemula, tantangan utamanya bukan sekadar memasang aplikasi, melainkan memilih model yang sesuai dengan kemampuan RAM, GPU, VRAM, prosesor, dan penyimpanan perangkat. Dengan memahami kebutuhan hardware dan karakter setiap model, TEKNOLOGI AI lokal dapat digunakan untuk menulis, merangkum dokumen, membantu pemrograman, hingga berbagai eksperimen secara lebih privat dan fleksibel.
Memahami Kemampuan Perangkat Menjadi Langkah Awal Menjalankan LLM Offline
Hal pertama sebelum menjalankan LLM offline adalah mengetahui kapasitas hardware yang tersedia. RAM, kartu grafis serta memori video, unit pemrosesan utama, serta ruang penyimpanan akan menentukan konfigurasi LLM yang sesuai. Semakin besar model, biasanya semakin banyak sumber daya yang diperlukan.
Bagi pemula, model berukuran besar belum tentu menjadi pilihan terbaik. Model dengan kebutuhan memori moderat sering memberikan pengalaman awal yang lebih baik karena waktu respons dapat lebih cepat. Target yang ideal adalah keseimbangan antara kualitas dan performa, bukan sekadar mengejar jumlah parameter.
RAM dan VRAM Menjadi Faktor Penting dalam Menentukan Ukuran Model
RAM dan VRAM menjadi komponen utama ketika menentukan model AI offline. Memori sistem dapat digunakan untuk menjalankan berbagai komponen inferensi, sementara VRAM menjadi sangat penting ketika pemrosesan menggunakan GPU. Ketika model terlalu berat, sistem dapat mengalami penurunan responsivitas.
Karena itu, pengguna sebaiknya menyisakan ruang memori untuk sistem operasi. Laptop dengan RAM terbatas dapat memilih model kompak terlebih dahulu. PC dengan RAM dan VRAM lebih besar memiliki pilihan model yang lebih banyak. Strategi seperti ini membantu menemukan konfigurasi ideal lebih cepat.
Jangan Hanya Melihat Besarnya Model ketika Memilih AI Lokal
Ukuran sebuah model memang memberikan gambaran mengenai kompleksitas model, tetapi bukan satu satunya ukuran kualitas. Model ringan yang dioptimalkan secara tepat dapat memberikan hasil yang sangat berguna untuk kebutuhan sehari hari.
Ketika menentukan LLM, pertimbangkan jenis pekerjaan seperti membantu penulisan, pemrograman, mengolah informasi panjang, atau percakapan umum. Model khusus pengembangan software, misalnya, dapat lebih sesuai untuk pekerjaan teknis dibandingkan LLM yang lebih berorientasi percakapan. Pendekatan berbasis kebutuhan membuat TEKNOLOGI AI tidak sekadar menghabiskan sumber daya.
Model Terkuantisasi Membantu LLM Berjalan pada Hardware Lebih Ringan
Kuantisasi merupakan metode yang berguna bagi pengguna yang menginginkan inferensi lebih efisien. Menggunakan pendekatan tersebut, representasi bobot model dapat dioptimalkan untuk mengurangi ukuran, sehingga penggunaan memori menjadi lebih ringan.
Namun, tingkat kuantisasi perlu dipilih secara proporsional karena konfigurasi yang terlalu ringan dapat memengaruhi kualitas respons. Bagi pengguna baru, model terkuantisasi dengan keseimbangan kualitas dan ukuran biasanya dapat memberikan pengalaman yang seimbang. Sesudah mengetahui kemampuan perangkat, pengguna dapat melakukan eksperimen lebih lanjut.
Pahami Perbedaan Menjalankan LLM dengan CPU dan GPU
LLM lokal tidak selalu harus dijalankan dengan kartu grafis diskrit. Beberapa runtime dan format model memungkinkan pemrosesan menggunakan CPU. Metode tersebut dapat menjadi pilihan untuk laptop standar, meskipun performa bergantung pada kemampuan prosesor.
Jika GPU tersedia, sebagian proses inferensi dapat dipindahkan ke GPU. Dalam kondisi yang sesuai, respons dapat terasa lebih lancar. Namun, kapasitas VRAM tetap perlu diperhatikan, sehingga model besar belum tentu dapat dimuat sepenuhnya.
Runtime AI Lokal Menyederhanakan Proses Memasang dan Menjalankan Model
Sesudah menentukan ukuran model, langkah berikutnya adalah memilih runtime lokal. Perangkat lunak inferensi berfungsi untuk menjalankan file LLM serta menghubungkan model dengan aplikasi. Bagi pemula, aplikasi dengan pengaturan sederhana dapat membuat eksperimen lebih nyaman.
Pemula yang belum terbiasa dengan terminal dapat menggunakan runtime dengan antarmuka grafis. Sementara itu, mereka yang membutuhkan otomatisasi dapat menggunakan layanan dengan API lokal agar dapat dihubungkan dengan aplikasi sendiri. Pilihan terbaik bukan selalu perangkat lunak paling kompleks, melainkan yang sesuai kebutuhan pengguna.
Atur Context Window dan Penggunaan Memori agar Performa Tetap Nyaman
Spesifikasi model bukan satu satunya penentu dalam menjaga performa AI lokal. Context window juga dapat memengaruhi kebutuhan memori. Apabila percakapan menjadi semakin panjang, sistem dapat menggunakan sumber daya lebih besar.
Bagi pemula, gunakan context window sesuai kebutuhan dan sisakan sumber daya untuk runtime AI. Perhatikan pula beban sistem, kapasitas grafis, serta suhu CPU dan GPU. Apabila respons menjadi sangat lambat, turunkan ukuran model hingga TEKNOLOGI AI dapat digunakan tanpa membebani perangkat secara berlebihan.
Kesimpulan, Pemula Sebaiknya Memulai LLM Offline dari Model yang Sesuai Perangkat
Menggunakan AI secara lokal tidak harus membutuhkan perangkat paling mahal. Faktor utama adalah memahami kemampuan laptop atau PC, kemudian menggunakan model berdasarkan kebutuhan. Kapasitas memori, tingkat kuantisasi, serta cara model dijalankan bersama sama memengaruhi performa AI lokal.
Untuk pengguna yang baru mencoba, gunakan konfigurasi sederhana terlebih dahulu, kemudian coba model lebih besar setelah memahami performa. Menurut Anda, apakah LLM offline akan berkembang menjadi alternatif penting seiring TEKNOLOGI komputasi lokal terus berkembang? Sampaikan pengalaman Anda mengenai penggunaan LLM lokal dan ikuti pembahasan berikutnya untuk mengetahui cara mengoptimalkan LLM.