Tips Mengoptimalkan GPU untuk AI Lokal, Cara Mempercepat Inferensi dan Menekan Beban Sistem
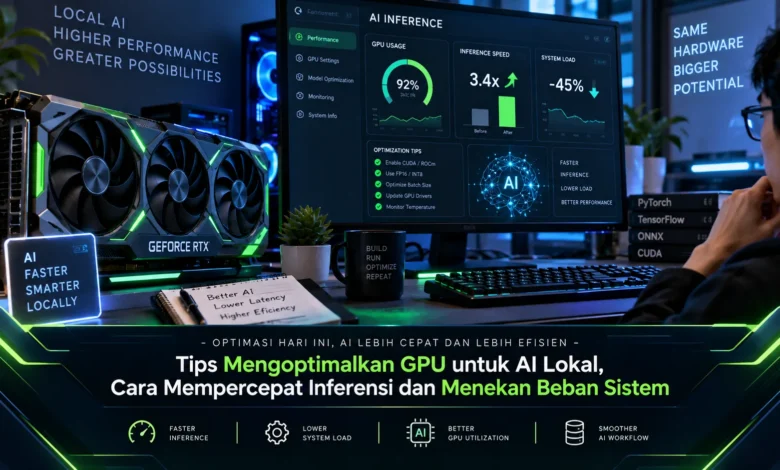
Menjalankan AI secara lokal semakin menarik karena pengguna dapat memproses model langsung melalui komputer sendiri tanpa selalu bergantung pada layanan cloud. Namun, performa AI lokal sangat dipengaruhi oleh kemampuan GPU, kapasitas VRAM, ukuran model, serta konfigurasi software yang digunakan. Dengan optimasi yang tepat, inferensi dapat berjalan lebih cepat sekaligus menjaga beban sistem tetap terkendali. Pendekatan ini semakin relevan dalam perkembangan TEKNOLOGI AI ketika model lokal mulai digunakan untuk berbagai kebutuhan produktivitas dan eksperimen.
Kenali Kebutuhan Model Sebelum Mengoptimalkan GPU
Langkah awal dalam mengoptimalkan GPU untuk AI lokal ialah mengetahui kebutuhan komputasi dari model yang digunakan. Setiap model memiliki kebutuhan VRAM dan komputasi yang berbeda, sehingga model berukuran besar belum tentu menjadi pilihan paling efisien. Arsitektur yang cocok dengan spesifikasi hardware biasanya dapat memberikan inferensi yang lebih stabil.
Kapasitas memory GPU perlu diperiksa sebelum model dimuat karena bobot model serta data sementara harus berada di memory ketika diproses. Apabila memory GPU hampir seluruhnya terpakai, sistem dapat kehilangan ruang untuk menangani operasi tambahan. Dengan menyesuaikan model terhadap hardware yang dimiliki, pengguna dapat memperoleh keseimbangan yang lebih baik antara kualitas model dan performa sistem.
Manajemen Memory Menjadi Kunci Performa AI Lokal
Memory GPU menjadi salah satu komponen utama saat model kecerdasan buatan diproses langsung pada perangkat. Ketika model berhasil dimuat sepenuhnya pada GPU, pemrosesan berpotensi berlangsung lebih cepat dibandingkan konfigurasi yang sering melakukan pertukaran data antara VRAM dan memory utama.
Menutup aplikasi yang tidak diperlukan bisa memberikan ruang memory tambahan bagi model. Program grafis, browser dengan banyak proses, permainan, dan aplikasi video berpotensi mengurangi ruang yang tersedia untuk proses inferensi. Tidak menggunakan seluruh kapasitas VRAM sejak awal membantu menjaga stabilitas saat workload membutuhkan alokasi tambahan. Pengaturan sederhana tersebut menjadi salah satu cara praktis mengoptimalkan TEKNOLOGI AI lokal dengan perangkat yang sudah tersedia.
Quantization Membantu Model Besar Berjalan Lebih Ringan
Quantization menjadi salah satu teknik yang banyak digunakan untuk menjalankan model AI secara lokal. Metode tersebut menyimpan parameter menggunakan format numerik yang lebih ringkas, sehingga kebutuhan memory dapat turun secara signifikan. Format dengan precision lebih rendah dapat membuat model berukuran besar lebih mudah dijalankan pada GPU konsumen.
Tingkat pengurangan precision sebaiknya tidak dipilih secara sembarangan. Precision yang semakin rendah dapat menghemat memory lebih banyak, namun hasil inferensi tertentu mungkin mengalami penurunan kualitas. Oleh sebab itu, pengujian pada workload nyata menjadi langkah yang penting agar diperoleh kombinasi performa dan kualitas yang sesuai.
Atur Context dan Batch Size agar GPU Tidak Terbebani
Bukan hanya bobot model, panjang context juga dapat memengaruhi kebutuhan memory selama inferensi. Konteks dengan jumlah token lebih besar berpotensi meningkatkan kebutuhan memory untuk mempertahankan informasi pemrosesan. Ketika tugas tidak memerlukan riwayat yang terlalu luas, membatasi konteks sesuai kebutuhan dapat membuat penggunaan GPU lebih efisien.
Ukuran batch merupakan konfigurasi lain yang perlu disesuaikan. Jumlah batch yang melampaui kemampuan perangkat dapat memberikan tekanan besar pada kapasitas GPU, sedangkan ukuran yang sangat rendah dapat mengurangi efisiensi pemrosesan. Ukuran batch dapat diuji dari konfigurasi rendah menuju lebih tinggi sembari membandingkan respons model dan utilisasi GPU. Metode penyesuaian bertahap tersebut dapat membantu menentukan pengaturan yang sesuai dengan perangkat.
Framework yang Tepat Bisa Meningkatkan Performa AI Lokal
Kemampuan hardware bukan satu satunya faktor yang menentukan performa model. Lingkungan software, backend pemrosesan, driver, serta konfigurasi inferensi berpotensi memengaruhi kecepatan dan penggunaan sumber daya. Software yang mampu memanfaatkan akselerasi GPU secara baik berpotensi meningkatkan throughput sekaligus menjaga penggunaan memory.
Pembagian workload antara GPU dan CPU dapat diatur berdasarkan sumber daya yang tersedia. Jika VRAM mencukupi, bagian model yang diakselerasi kartu grafis dapat diperbesar untuk mengurangi ketergantungan terhadap CPU. Jika VRAM terbatas, pembagian komputasi dapat dilakukan antara GPU dengan sistem utama, meski respons model mungkin menjadi lebih lambat. Mengatur offloading secara seimbang dapat membantu memperoleh performa terbaik dari perangkat yang tersedia.
Identifikasi Hambatan Sistem Sebelum Mengubah Hardware
Penyesuaian konfigurasi sebaiknya didasarkan pada hasil monitoring. Beban GPU, kapasitas VRAM, aktivitas CPU, penggunaan RAM, temperatur perangkat, serta respons model sebaiknya diperhatikan ketika model sedang melakukan inferensi. Data monitoring tersebut dapat memperlihatkan sumber hambatan performa.
Apabila kartu grafis tidak digunakan secara maksimal sementara prosesor mengalami beban besar, workload mungkin masih terlalu bergantung pada CPU. Jika VRAM selalu penuh, konfigurasi model dan kebutuhan memory sebaiknya ditinjau kembali. Suhu GPU yang terus meningkat dapat menyebabkan sistem menurunkan performa untuk menjaga perangkat. Melalui monitoring sebelum melakukan perubahan, penyesuaian dapat difokuskan pada sumber masalah sebenarnya.
Penutup
Meningkatkan performa AI lokal tidak hanya membutuhkan GPU cepat tetapi juga konfigurasi model dan sumber daya yang tepat. Pemilihan model realistis, manajemen VRAM, precision yang efisien, konfigurasi context, batch, serta pembagian workload berpotensi memberikan respons lebih cepat tanpa membebani perangkat secara berlebihan.
Monitoring tetap menjadi bagian penting dari seluruh proses sebab konfigurasi terbaik dapat berbeda antara satu sistem dengan sistem lainnya. Pertumbuhan TEKNOLOGI model lokal membuat optimasi sumber daya semakin relevan bagi pengguna. Dengan membandingkan konfigurasi berdasarkan kecepatan serta penggunaan memory, pengguna dapat menemukan konfigurasi AI lokal yang cepat, stabil, dan sesuai kebutuhan. Pembaca dapat membandingkan beberapa pengaturan untuk menemukan kombinasi terbaik bagi workload AI lokal masing masing.