DeepSeek Buka Kode DeepInfer untuk Mendukung Pemrosesan Model AI pada Berbagai Chip
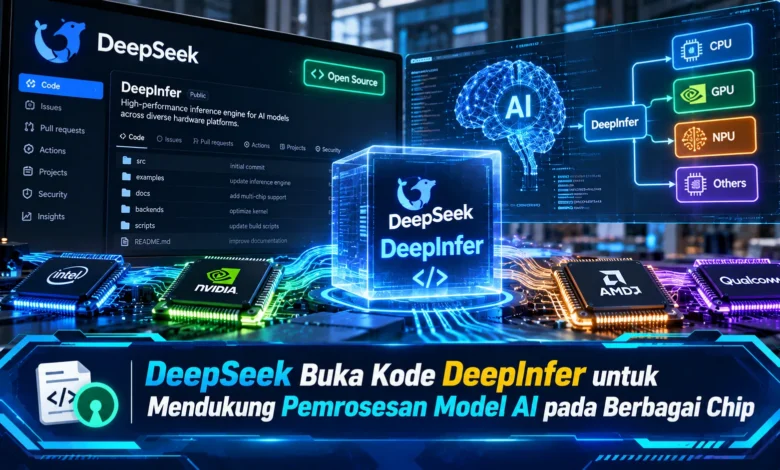
DeepSeek kembali menarik perhatian industri kecerdasan buatan setelah membuka kode sumber DeepInfer pada 20 Oktober 2026. Framework inferensi ini dirancang untuk membantu menjalankan model AI berskala besar dengan lebih efisien, terutama pada infrastruktur yang menggunakan jenis chip berbeda. Dalam rilis awalnya, DeepInfer mendukung GPU Nvidia berarsitektur SM100 serta NPU Huawei Ascend 950. Langkah tersebut memperlihatkan upaya DeepSeek memperluas pilihan perangkat keras tanpa mengabaikan kebutuhan performa dan efisiensi komputasi. Perkembangan TEKNOLOGI ini membuka peluang bagi pengembang dan perusahaan untuk mempelajari sistem inferensi yang digunakan dalam layanan DeepSeek, sekaligus memahami tantangan penerapannya pada pusat data modern.
Mengenal DeepInfer sebagai Framework AI Terbuka dari DeepSeek
Framework DeepInfer hadir sebagai sistem pemrosesan model kecerdasan buatan yang dikembangkan guna menangani pelayanan permintaan kecerdasan buatan dalam jumlah tinggi. Tidak sama dengan proses pelatihan model yang menggunakan data untuk menyesuaikan bobot jaringan, inferensi berkaitan dengan penggunaan model untuk menghasilkan keluaran. Pada tahap tersebut, sistem bertugas menangani permintaan dan memberikan jawaban dalam waktu yang sesuai. DeepInfer dirancang untuk mengelola proses tersebut secara terdistribusi. Melalui rancangan tersebut, DeepSeek memberikan alternatif bagi pengembang infrastruktur AI.
Dirilisnya framework DeepInfer secara terbuka memberikan kontribusi baru dalam ekosistem perangkat lunak AI. Proyek sumber terbuka ini tersedia melalui GitHub menggunakan lisensi Apache 2.0. Ketentuan sumber terbuka tersebut mendukung pemanfaatan perangkat lunak sesuai persyaratan lisensi yang berlaku. Sistem inferensi tersebut memanfaatkan pengalaman pengelolaan layanan AI DeepSeek untuk mendukung layanan kecerdasan buatan berskala produksi. Walaupun telah digunakan dalam lingkungan DeepSeek, rilis publiknya masih memiliki batasan dibandingkan sistem internal lengkap. Karena itu, pengembang harus membedakan kemampuan kode publik dan infrastruktur internal.

Kompatibilitas DeepInfer dengan Berbagai Arsitektur Chip AI
Kemampuan yang paling menonjol adalah dukungan terhadap dua keluarga akselerator berbeda. Berdasarkan dukungan perangkat keras yang diumumkan, DeepInfer menyediakan jalur pemrosesan untuk keluarga GPU SM100 Nvidia dan NPU Huawei Ascend 950. Kompatibilitas awal ini memperlihatkan pendekatan lintas platform. Pada banyak lingkungan komputasi, variasi perangkat lunak pendukung chip dapat mempersulit pemindahan sistem. Berkat pengembangan lintas akselerator, DeepSeek memperluas pilihan infrastruktur bagi operator AI. Kendati memiliki pendekatan multi-hardware, penggunaan tetap terbatas pada perangkat yang didukung secara resmi.
Variasi teknologi akselerator membuat optimasi inferensi menjadi pekerjaan kompleks. Akselerator grafis Nvidia memanfaatkan perangkat lunak CUDA untuk menjalankan operasi pemrosesan paralel. Sementara itu, Huawei Ascend menggunakan perangkat pengembangan CANN yang dirancang untuk akselerator Ascend. Kondisi lintas platform ini memerlukan penyesuaian kernel dan dependensi. Dengan pertimbangan tersebut, kemampuan lintas chip tidak berarti kode mesin selalu sama. Pengembang tetap perlu memeriksa kompatibilitas sistem sebelum menggunakan framework secara luas.
Teknologi DeepInfer untuk Meningkatkan Kecepatan Inferensi AI
Sistem inferensi DeepSeek tersebut memanfaatkan berbagai teknologi percepatan model seperti FlashMLA, DeepGEMM, DeepEP, dan TileKernels. Berbagai pustaka tersebut membantu mengoptimalkan pekerjaan matematika model. Komponen pengolahan attention FlashMLA mendukung perhitungan attention secara efisien, sedangkan DeepGEMM menangani komputasi matriks berkecepatan tinggi. DeepEP digunakan untuk kebutuhan komunikasi antarproses. Dengan menggabungkan komponen tersebut, framework mendukung pengolahan permintaan secara lebih efisien. Walaupun pustaka tersebut dirancang berkinerja tinggi, manfaat sebenarnya bergantung pada model dan konfigurasi.
Selain optimasi kernel, DeepInfer menyediakan pengaturan distributed inference melalui attention data parallelism, context parallelism, serta mixture-of-experts expert parallelism. Pendekatan tersebut mendukung pembagian tugas pada infrastruktur dengan banyak chip. Pada arsitektur AI berbasis MoE, hanya sejumlah expert dipilih untuk token tertentu. Framework ini turut mendukung expert parallel load balancing agar pekerjaan tidak terkonsentrasi pada perangkat tertentu. Tidak kalah penting, DeepInfer mendukung pengaturan pekerjaan tanpa menunggu secara berlebihan untuk mendukung penggunaan sumber daya yang lebih optimal. Pendekatan pemrosesan tersebut menjadi fondasi inferensi berskala besar.
Kemampuan DeepInfer Mempercepat Pembangkitan Token AI
Teknologi optimasi yang turut disediakan DeepInfer adalah speculative decoding. Metode tersebut dirancang mempercepat proses generasi jawaban dengan membuat token draf sebelum diverifikasi. Pada sistem yang dikembangkan DeepSeek, digunakan teknologi DSpark bersama confidence-scheduled verification untuk mengoptimalkan pemeriksaan token spekulatif. Optimasi decoding tersebut dapat mengurangi hambatan pembangkitan pada jenis pekerjaan yang mendukung. Namun demikian, hasil penggunaan bergantung pada kondisi pemrosesan. Untuk menilai keuntungan sebenarnya, pengujian performa tetap diperlukan berdasarkan jenis permintaan pengguna.
Selain percepatan token, framework ini menghadirkan fitur structured outputs yang memungkinkan pembatasan format respons. Melalui kemampuan tersebut, model mampu mengikuti pola ekspresi reguler berdasarkan ketentuan format yang digunakan. Dukungan format khusus memiliki manfaat bagi pengembangan layanan digital yang mengandalkan struktur informasi tertentu. Dalam penerapan praktis, aplikasi pengelolaan dokumen berpeluang menggunakan keluaran dengan struktur baku berisi status klasifikasi. Berkat pengendalian susunan respons, aplikasi lain lebih mudah membaca hasil. Meski demikian, pemeriksaan hasil masih diperlukan sebelum digunakan untuk keputusan penting.
Cara Memulai DeepInfer dan Batasan Rilis Sumber Terbuka
Bagi pengguna yang tertarik menjalankan framework ini sebaiknya memeriksa persyaratan instalasi terlebih dahulu. Dalam petunjuk pengembangan resmi, DeepInfer menggunakan Linux sebagai platform sistem operasi, Python 3.12, serta GCC versi 13 atau lebih baru. Pada konfigurasi berbasis Nvidia, lingkungan harus mendukung CUDA versi 13. Di sisi lain, implementasi Ascend membutuhkan CANN 9.2. Ketika lingkungan sudah disiapkan, pengguna dapat menyiapkan berkas framework resmi. Dalam proses instalasi, jenis akselerator perlu ditentukan melalui variabel DEEPINFER_ACCELERATOR dengan nilai nvidia atau ascend. Proses tersebut menghindari penggunaan dependensi perangkat yang keliru.
Ketika framework selesai dikompilasi, pengguna dapat menjalankan contoh inferensi offline. Pada rilis saat ini, DeepInfer difokuskan pada model DeepSeek-V4.1-Flash. Model tersebut tersedia melalui repositori model yang sesuai, dengan kebutuhan perangkat keras yang harus diperhitungkan. Kendati teknologinya dikembangkan untuk layanan skala besar, rilis sumber terbuka tidak mencakup keseluruhan komponen operasional produksi. Komponen tambahan yang masih dibutuhkan mencakup manajemen cache konteks model, mekanisme disaggregated deployment secara lengkap, serta load balancing antar-replika. Karena itu, operator perlu membangun pengelolaan layanan tersendiri.
Masa Depan Inferensi Kecerdasan Buatan dengan Dukungan Multi-Chip
Hadirnya DeepInfer sebagai proyek sumber terbuka mendorong penelitian komputasi kecerdasan buatan. Dukungan terhadap Nvidia dan Huawei menunjukkan bahwa optimasi lintas vendor semakin penting. Selama ini, integrasi akselerator menjadi faktor penting dalam keputusan infrastruktur. Jika dukungan DeepInfer berkembang, operator dapat mengevaluasi alternatif komputasi dengan lebih fleksibel. Namun demikian, kinerja pada setiap arsitektur harus dibandingkan secara objektif. Aspek yang perlu dievaluasi mencakup kecepatan respons, jumlah permintaan yang diproses, kebutuhan daya listrik, serta total biaya pengoperasian layanan.
Selain memperluas pilihan perangkat keras, publikasi kode DeepInfer mendukung penelitian terhadap sistem pemrosesan terdistribusi. Peneliti berpeluang mempelajari implementasi kernel, membandingkan berbagai konfigurasi, serta mengembangkan perbaikan yang sesuai. Melalui ketentuan sumber terbuka tersebut, kontribusi perangkat lunak berpotensi berkembang. Namun, biaya komputasi masih perlu dipertimbangkan. Model besar membutuhkan kapasitas memori tinggi. Oleh sebab itu, pengembang perlu memahami kompleksitas penerapan sebelum memindahkan sistem penting ke framework baru.
Perkembangan TEKNOLOGI AI melalui Framework Terbuka DeepInfer
Hadirnya DeepInfer sebagai perangkat lunak terbuka memberikan kontribusi baru dalam industri pemrosesan AI modern. Melalui kompatibilitas GPU Nvidia SM100 dan NPU Huawei Ascend 950, DeepInfer memperlihatkan pendekatan lintas perangkat keras. Integrasi teknologi percepatan komputasi, paralelisme, speculative decoding, dan keluaran terstruktur berpotensi meningkatkan kemampuan pemrosesan model. Walaupun fiturnya cukup luas, penggunaan tetap memerlukan perangkat keras yang sesuai. Dengan mempertimbangkan batasan ini, pengujian kompatibilitas dan performa menjadi langkah penting. Di tengah persaingan industri chip AI, DeepInfer dapat membantu penelitian sistem inferensi. Bagaimana pendapat Anda, apakah framework multi-chip seperti DeepInfer akan mendorong persaingan yang lebih sehat dalam industri komputasi? Bagikan pendapat Anda mengenai masa depan DeepInfer.