Tips Mengoptimalkan GPU untuk AI Lokal, Cara Mempercepat Inferensi dan Menekan Beban Sistem
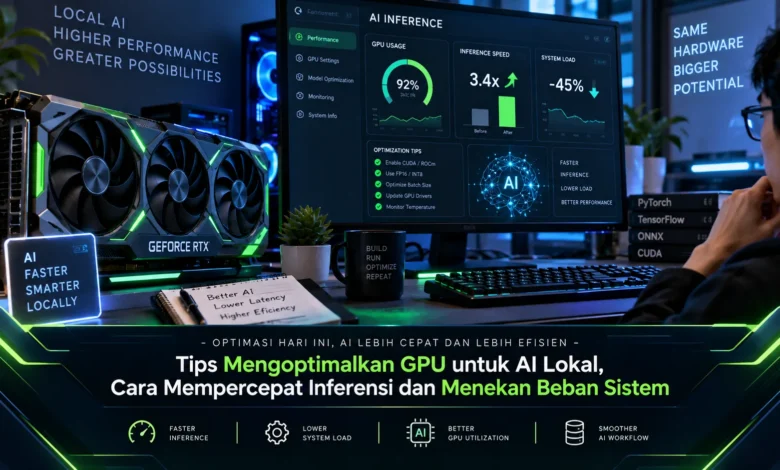
Menjalankan AI secara lokal semakin menarik karena pengguna dapat memproses model langsung melalui komputer sendiri tanpa selalu bergantung pada layanan cloud. Namun, performa AI lokal sangat dipengaruhi oleh kemampuan GPU, kapasitas VRAM, ukuran model, serta konfigurasi software yang digunakan. Dengan optimasi yang tepat, inferensi dapat berjalan lebih cepat sekaligus menjaga beban sistem tetap terkendali. Pendekatan ini semakin relevan dalam perkembangan TEKNOLOGI AI ketika model lokal mulai digunakan untuk berbagai kebutuhan produktivitas dan eksperimen.
Pahami Beban Model agar Inferensi Lokal Lebih Efisien
Tahap pertama untuk meningkatkan performa AI lokal ialah mengetahui kebutuhan komputasi dari model yang digunakan. Setiap model memiliki kebutuhan VRAM dan komputasi yang berbeda, sehingga memilih model terbesar belum tentu memberikan pengalaman penggunaan terbaik. Model yang seimbang dengan kemampuan GPU cenderung mampu berjalan dengan respons yang lebih konsisten.
Kapasitas memory GPU perlu diperiksa sebelum model dimuat karena bobot model serta data sementara harus berada di memory ketika diproses. Jika penggunaan VRAM terlalu mendekati kapasitas maksimum, workload dapat mengalami tekanan memory saat konteks maupun data bertambah. Dengan memilih ukuran model secara realistis, pengguna dapat memperoleh keseimbangan yang lebih baik antara kualitas model dan performa sistem.
Atur Penggunaan VRAM untuk Mengurangi Beban Sistem
Kapasitas memori grafis memiliki peranan besar saat model kecerdasan buatan diproses langsung pada perangkat. Apabila model dan operasi penting dapat diproses melalui GPU, inferensi biasanya dapat berjalan lebih efisien dibandingkan ketika terlalu banyak data harus berpindah antara GPU dan memory sistem.
Menghentikan software yang mengonsumsi memory grafis secara tidak penting dapat membantu menyediakan lebih banyak VRAM untuk AI. Program grafis, browser dengan banyak proses, permainan, dan aplikasi video dapat menggunakan sebagian VRAM meskipun bukan bagian dari workload AI. Tidak menggunakan seluruh kapasitas VRAM sejak awal membantu menjaga stabilitas saat workload membutuhkan alokasi tambahan. Pendekatan pengelolaan memory ini bisa meningkatkan kenyamanan penggunaan tanpa membutuhkan GPU baru.
Quantization Membantu Model Besar Berjalan Lebih Ringan
Quantization menjadi salah satu teknik yang banyak digunakan untuk membuat inferensi lokal menjadi lebih ringan. Quantization mengurangi jumlah bit yang diperlukan untuk menyimpan sebagian informasi model, yang membuat konsumsi VRAM berpotensi menjadi lebih rendah. Representasi bobot yang lebih ringkas dapat membantu pengguna menjalankan model lokal menggunakan sumber daya yang lebih realistis.
Tingkat pengurangan precision sebaiknya tidak dipilih secara sembarangan. Precision yang semakin rendah dapat menghemat memory lebih banyak, tetapi kualitas output pada sebagian model dapat mengalami perubahan. Oleh sebab itu, pengujian pada workload nyata menjadi langkah yang penting supaya konfigurasi akhir memberikan efisiensi tanpa mengorbankan hasil secara berlebihan.
Konfigurasi Batch dan Context Membantu Menjaga Efisiensi
Di samping parameter model, panjang context juga dapat memengaruhi kebutuhan memory selama inferensi. Context yang semakin panjang dapat membuat penggunaan VRAM bertambah seiring meningkatnya data yang harus dipertahankan. Apabila workload hanya membutuhkan percakapan atau dokumen berukuran sedang, membatasi konteks sesuai kebutuhan dapat membuat penggunaan GPU lebih efisien.
Ukuran batch merupakan konfigurasi lain yang perlu disesuaikan. Jumlah batch yang melampaui kemampuan perangkat dapat memberikan tekanan besar pada kapasitas GPU, sedangkan ukuran yang sangat rendah dapat mengurangi efisiensi pemrosesan. Pengguna dapat menaikkan batch secara bertahap sambil memantau penggunaan VRAM dan kecepatan inferensi. Strategi eksperimen seperti ini membuat optimalisasi TEKNOLOGI AI menjadi lebih terukur.
Framework yang Tepat Bisa Meningkatkan Performa AI Lokal
Kemampuan hardware bukan satu satunya faktor yang menentukan performa model. Runtime AI, library akselerasi, driver GPU, dan pengaturan aplikasi berpotensi memengaruhi kecepatan dan penggunaan sumber daya. Runtime yang mendukung kemampuan komputasi perangkat secara tepat berpotensi meningkatkan throughput sekaligus menjaga penggunaan memory.
Pengguna dapat menentukan seberapa banyak bagian model yang diproses melalui kartu grafis. Ketika kartu grafis memiliki ruang memory yang memadai, porsi pemrosesan melalui GPU dapat ditingkatkan sehingga sebagian besar komputasi berat dapat ditangani GPU. Jika VRAM terbatas, pembagian komputasi dapat dilakukan antara GPU dengan sistem utama, meski respons model mungkin menjadi lebih lambat. Mengatur offloading secara seimbang menjadi langkah penting untuk mengoptimalkan TEKNOLOGI AI lokal.
Pantau Suhu dan Utilisasi untuk Menemukan Bottleneck
Pengaturan performa akan lebih tepat jika menggunakan informasi penggunaan perangkat. Utilisasi GPU, konsumsi VRAM, penggunaan CPU, RAM, temperatur, serta kecepatan inferensi dapat digunakan untuk mengetahui kondisi sistem saat AI aktif. Data monitoring tersebut membantu menunjukkan bagian mana yang menjadi bottleneck.
Ketika aktivitas GPU rendah sedangkan penggunaan CPU mendekati batas, pembagian komputasi mungkin belum memanfaatkan GPU secara optimal. Apabila memory GPU terus berada pada kapasitas maksimum, pengguna dapat memeriksa kembali precision, panjang konteks, cache, serta model. Temperatur yang terlalu tinggi dalam waktu lama dapat menyebabkan sistem menurunkan performa untuk menjaga perangkat. Dengan memahami bottleneck terlebih dahulu, pengguna dapat melakukan optimasi pada bagian yang benar.
Optimasi GPU Membuat AI Lokal Lebih Cepat dan Efisien
Optimalisasi AI lokal memerlukan penyesuaian antara kebutuhan model, memory GPU, software, serta spesifikasi perangkat. Pemilihan model realistis, manajemen VRAM, precision yang efisien, konfigurasi context, batch, serta pembagian workload berpotensi memberikan respons lebih cepat tanpa membebani perangkat secara berlebihan.
Pemantauan performa sebaiknya tetap dilakukan setelah setiap perubahan sebab konfigurasi terbaik dapat berbeda antara satu sistem dengan sistem lainnya. Perkembangan TEKNOLOGI AI lokal yang semakin cepat mendorong pengguna untuk memanfaatkan kemampuan perangkat secara lebih cermat. Melalui eksperimen terukur terhadap model dan pengaturan sistem, pengguna dapat menemukan konfigurasi AI lokal yang cepat, stabil, dan sesuai kebutuhan. Pembaca dapat mencoba setiap langkah secara bertahap untuk mengetahui optimasi mana yang memberikan peningkatan terbesar.