DeepSeek Buka Kode DeepInfer untuk Mendukung Pemrosesan Model AI pada Berbagai Chip
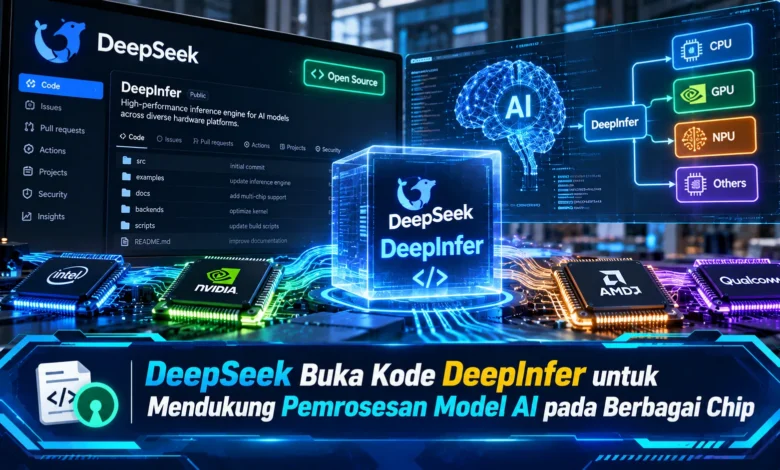
DeepSeek kembali menarik perhatian industri kecerdasan buatan setelah membuka kode sumber DeepInfer pada 20 Oktober 2026. Framework inferensi ini dirancang untuk membantu menjalankan model AI berskala besar dengan lebih efisien, terutama pada infrastruktur yang menggunakan jenis chip berbeda. Dalam rilis awalnya, DeepInfer mendukung GPU Nvidia berarsitektur SM100 serta NPU Huawei Ascend 950. Langkah tersebut memperlihatkan upaya DeepSeek memperluas pilihan perangkat keras tanpa mengabaikan kebutuhan performa dan efisiensi komputasi. Perkembangan TEKNOLOGI ini membuka peluang bagi pengembang dan perusahaan untuk mempelajari sistem inferensi yang digunakan dalam layanan DeepSeek, sekaligus memahami tantangan penerapannya pada pusat data modern.
DeepSeek Memperkenalkan DeepInfer untuk Infrastruktur Kecerdasan Buatan
DeepSeek mengembangkan DeepInfer sebagai mesin inferensi untuk menjalankan model bahasa besar yang bertujuan mengoptimalkan beban kerja AI berskala besar. Berbeda dari proses pelatihan model yang menggunakan data untuk menyesuaikan bobot jaringan, inferensi berfungsi memproses permintaan menggunakan kemampuan model yang tersedia. Pada tahap tersebut, sistem harus mengolah input dan menghasilkan respons secara efisien. Framework ini dikembangkan untuk mengelola proses tersebut secara terdistribusi. Berkat kemampuan tersebut, DeepSeek membuka kesempatan mempelajari pengelolaan model skala besar.
Dirilisnya framework DeepInfer secara terbuka memberikan kontribusi baru dalam komunitas pengembangan model bahasa. Kode tersebut dapat diakses pada repositori resmi DeepSeek menggunakan lisensi Apache 2.0. Skema distribusi perangkat lunak ini memberikan ruang pengembangan lanjutan sesuai ketentuan Apache 2.0. Framework yang baru dirilis ini dikembangkan berdasarkan kebutuhan operasional DeepSeek untuk mengoptimalkan pemrosesan model pada infrastruktur nyata. Walaupun telah digunakan dalam lingkungan DeepSeek, rilis publiknya tidak otomatis menyediakan semua kebutuhan operasional pusat data. Karena itu, pengembang perlu mempelajari fitur yang telah tersedia.
Teknologi Multi-Hardware DeepSeek untuk Inferensi Model Besar
Salah satu keunggulan utama adalah kompatibilitas dengan platform komputasi Nvidia dan Huawei. Dalam versi awal, DeepInfer menyediakan jalur pemrosesan untuk keluarga GPU SM100 Nvidia dan akselerator AI Huawei Ascend 950. Pilihan perangkat keras tersebut menunjukkan pengembangan yang tidak hanya berfokus pada satu vendor. Pada banyak lingkungan komputasi, perbedaan arsitektur antarprodusen membutuhkan penyesuaian teknis tambahan. Melalui DeepInfer, DeepSeek memperluas pilihan infrastruktur bagi operator AI. Walaupun konsepnya mendukung berbagai chip, tidak berarti semua GPU dan NPU langsung kompatibel.
Perbedaan arsitektur perangkat keras menimbulkan kebutuhan penyesuaian perangkat lunak. Perangkat komputasi Nvidia menggunakan ekosistem CUDA untuk menjalankan operasi pemrosesan paralel. Sementara itu, Huawei Ascend mengandalkan lingkungan komputasi CANN yang dirancang untuk akselerator Ascend. Kondisi lintas platform ini memerlukan penyesuaian kernel dan dependensi. Karena itu, kemampuan lintas chip tidak berarti kode mesin selalu sama. Operator infrastruktur dianjurkan menilai dukungan pustaka yang diperlukan sebelum memindahkan pekerjaan penting.
Bagaimana DeepInfer Mengelola Beban Kerja Model Bahasa Besar?
DeepInfer menggunakan berbagai teknologi percepatan model seperti FlashMLA, DeepGEMM, DeepEP, dan TileKernels. Berbagai pustaka tersebut mendukung efisiensi komputasi pada akselerator. Komponen pengolahan attention FlashMLA berkaitan dengan optimasi mekanisme attention, sedangkan DeepGEMM berfokus pada operasi perkalian matriks. Sementara pustaka DeepEP mendukung komunikasi pada sistem expert parallelism. Dengan menggabungkan komponen tersebut, framework dapat meningkatkan pemanfaatan akselerator. Meski menawarkan kemampuan optimasi, peningkatan performa perlu dibuktikan melalui benchmark.
Selain optimasi kernel, DeepInfer mendukung pemrosesan paralel melalui attention data parallelism, context parallelism, serta mixture-of-experts expert parallelism. Strategi pembagian komputasi tersebut mendukung pembagian tugas pada sekumpulan perangkat komputasi. Khusus model Mixture of Experts, hanya sejumlah expert dipilih untuk token tertentu. Framework ini turut mendukung expert parallel load balancing agar penggunaan akselerator lebih merata. Selain itu, penjadwalan asinkron digunakan untuk mendukung penggunaan sumber daya yang lebih optimal. Pendekatan pemrosesan tersebut membantu meningkatkan efisiensi penggunaan chip.
Kemampuan DeepInfer Mempercepat Pembangkitan Token AI
Fitur penting lainnya DeepInfer adalah mekanisme pembangkitan token spekulatif. Sistem decoding tersebut membantu meningkatkan kecepatan pembangkitan token dengan membuat token draf sebelum diverifikasi. Dalam implementasi DeepInfer, diintegrasikan pendekatan DSpark bersama confidence-scheduled verification untuk mengatur proses pemeriksaan token berdasarkan tingkat keyakinan. Pendekatan tersebut membantu mempercepat keluaran model pada sistem dengan karakteristik model tertentu. Meski menawarkan potensi percepatan, hasil penggunaan bergantung pada kondisi pemrosesan. Untuk menilai keuntungan sebenarnya, pengembang perlu membandingkan hasil benchmark berdasarkan jenis permintaan pengguna.
Untuk mendukung keluaran yang lebih terkontrol, tersedia fitur structured outputs yang membantu memastikan jawaban mengikuti aturan format. Dengan menggunakan fitur ini, model mampu mengikuti pola ekspresi reguler berdasarkan aturan yang disediakan pengembang. Fitur tersebut mendukung penggunaan AI pada sistem otomatis yang membutuhkan data mudah diproses. Sebagai contoh, aplikasi pengelolaan dokumen mampu mengolah respons yang mengikuti skema berisi ringkasan informasi. Melalui keluaran terstruktur, aplikasi lain lebih mudah membaca hasil. Walaupun formatnya terkontrol, pemeriksaan hasil masih diperlukan sebelum digunakan untuk keputusan penting.
Hal yang Perlu Diperhatikan Sebelum Menggunakan DeepInfer
Pengembang yang ingin mencoba DeepInfer perlu menyiapkan lingkungan komputasi yang sesuai. Menurut persyaratan yang tersedia, DeepInfer dirancang dijalankan pada lingkungan Linux, Python 3.12, serta GCC versi 13 atau lebih baru. Apabila menggunakan GPU Nvidia, lingkungan harus mendukung CUDA versi 13. Sementara itu, implementasi Ascend membutuhkan CANN 9.2. Ketika lingkungan sudah disiapkan, pengembang bisa mengunduh proyek melalui GitHub. Selanjutnya, lingkungan komputasi perlu disesuaikan melalui variabel DEEPINFER_ACCELERATOR dengan nilai nvidia atau ascend. Tahapan pengaturan ini menghindari penggunaan dependensi perangkat yang keliru.
Sesudah lingkungan pengembangan siap, pengguna memiliki kesempatan menguji kemampuan model secara lokal pada server. Berdasarkan dukungan model yang diumumkan, DeepInfer secara resmi mendukung DeepSeek-V4.1-Flash. Model tersebut dapat dimuat dari sumber checkpoint yang kompatibel, dengan penggunaan memori yang perlu dievaluasi. Walaupun framework ini digunakan pada infrastruktur DeepSeek, rilis sumber terbuka masih berfokus pada offline inference. Komponen tambahan yang masih dibutuhkan mencakup sistem pengelolaan KV cache, pemisahan layanan vision encoder, prefill, dan decode, serta penyeimbangan beban pada replika data parallel. Karena itu, pengembang harus menyiapkan komponen pendukung.
Masa Depan Inferensi Kecerdasan Buatan dengan Dukungan Multi-Chip
Keputusan DeepSeek membuka kode framework ini mendorong penelitian komputasi kecerdasan buatan. Kemampuan menjalankan model melalui GPU maupun NPU tertentu menunjukkan bahwa optimasi lintas vendor semakin penting. Dalam banyak sistem komputasi AI, integrasi akselerator menjadi faktor penting dalam keputusan infrastruktur. Jika dukungan DeepInfer berkembang, perusahaan mungkin dapat membandingkan beberapa jenis chip. Meski peluangnya menarik, biaya implementasi tetap perlu diperhitungkan. Pertimbangan teknis penting meliputi latensi layanan, jumlah permintaan yang diproses, efisiensi penggunaan energi, serta total biaya pengoperasian layanan.
Di samping aspek kompatibilitas chip, publikasi kode DeepInfer membuka ruang eksperimen dengan arsitektur model besar. Tim teknis memiliki kesempatan untuk memeriksa strategi paralelisme, menguji pengaruh pengaturan komputasi, serta mengembangkan perbaikan yang sesuai. Dengan lisensi Apache 2.0, kontribusi perangkat lunak berpotensi berkembang. Walaupun kode tersedia secara terbuka, penerapan skala produksi tidak otomatis sederhana. Model besar sering mengandalkan jaringan serta penyimpanan cepat. Karena itu, pengembang perlu memahami kompleksitas penerapan sebelum memindahkan sistem penting ke framework baru.
Kesimpulan DeepInfer dan Masa Depan Pemrosesan AI
Hadirnya DeepInfer sebagai perangkat lunak terbuka memberikan kontribusi baru dalam pengembangan infrastruktur model bahasa besar. Melalui kompatibilitas GPU Nvidia SM100 dan NPU Huawei Ascend 950, DeepInfer membuka pilihan arsitektur komputasi yang lebih beragam. Kombinasi teknologi percepatan komputasi, paralelisme, speculative decoding, dan keluaran terstruktur memberikan fondasi untuk inferensi efisien. Meski framework ini menjanjikan, rilis publik belum mencakup seluruh komponen produksi. Oleh sebab itu, penerapan harus direncanakan secara realistis. Di tengah persaingan industri chip AI, DeepInfer dapat membantu penelitian sistem inferensi. Dari sudut pandang Anda, apakah perangkat lunak inferensi lintas akselerator akan mengurangi ketergantungan terhadap satu produsen? Ceritakan pengalaman atau pemikiran Anda mengenai pengembangan inferensi AI sumber terbuka.