AI Inference Engine Optimization Makin Penting saat AI Beralih dari Cloud ke Perangkat Lokal
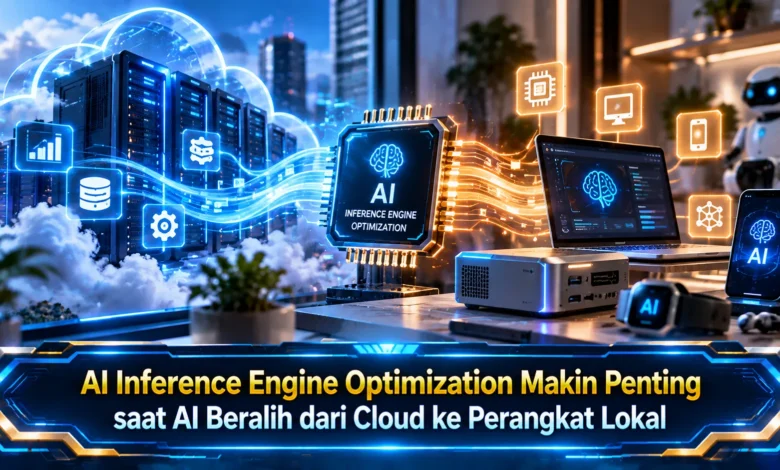
Perkembangan kecerdasan buatan mulai mendorong semakin banyak proses AI berjalan langsung pada smartphone, laptop, komputer, kendaraan, hingga perangkat edge tanpa selalu bergantung pada cloud. Perubahan ini membuat efisiensi inference menjadi semakin penting karena perangkat lokal memiliki batas daya, memori, temperatur, dan kemampuan komputasi. AI Inference Engine Optimization menjadi bagian penting dari perkembangan teknologi tersebut karena membantu model memanfaatkan CPU, GPU, NPU, memori, serta software secara lebih efisien agar pemrosesan AI lokal dapat berlangsung cepat dan responsif.
On Device AI Mengubah Cara Model Kecerdasan Buatan Dijalankan
Selama beberapa tahun, banyak layanan AI mengandalkan infrastruktur cloud dengan kapasitas komputasi besar. Data input diteruskan menuju server tempat inference dilakukan lalu hasil pemrosesan dikirim kembali kepada pengguna. Cloud tetap memiliki peran penting untuk model berskala besar, tetapi perkembangan perangkat keras membuka peluang bagi berbagai fungsi AI untuk dijalankan secara lokal.
Pemrosesan AI langsung pada perangkat menawarkan berbagai keuntungan yang dapat mencakup respons yang lebih cepat, pengurangan komunikasi dengan server, serta kemungkinan menjalankan sebagian fitur tanpa selalu terhubung ke internet. On device processing dapat membatasi kebutuhan mentransfer jenis data tertentu ke cloud ketika seluruh proses yang diperlukan tersedia secara lokal. Akan tetapi, manfaat tersebut diikuti tantangan karena teknologi AI lokal harus beroperasi dengan kapasitas yang lebih terbatas daripada server cloud.
AI Inference Engine Optimization Menjadi Kunci On Device AI
AI Inference Engine Optimization memiliki tujuan untuk cara menjalankan model yang telah dilatih secara lebih efisien ketika menerima input baru. Ketika inference berlangsung, model menggunakan hasil pembelajaran sebelumnya untuk menghasilkan prediksi, jawaban, klasifikasi, atau bentuk keluaran lainnya. Semakin kompleks sebuah model, semakin besar pula potensi kebutuhan komputasi dan memori yang harus dikelola.
Efisiensi menjadi faktor utama pada on device AI karena kemampuan komputasi harus diseimbangkan dengan konsumsi daya perangkat. Ponsel perlu menjaga penggunaan baterai, komputer portabel harus menyeimbangkan kecepatan dengan temperatur, sementara perangkat edge dapat memiliki keterbatasan memori dan energi. Oleh sebab itu, teknologi inference harus mengelola eksekusi model agar kemampuan perangkat dapat digunakan tanpa membebani sistem secara berlebihan.
NPU Semakin Penting untuk Menjalankan Beban Kerja AI
Smartphone dan laptop modern dapat menyediakan berbagai komponen pemrosesan untuk menangani tugas kecerdasan buatan. CPU menawarkan fleksibilitas untuk berbagai operasi, GPU memiliki kemampuan pemrosesan paralel yang kuat, sedangkan NPU dirancang untuk mempercepat jenis operasi AI tertentu secara lebih efisien. Kombinasi tersebut membuat perangkat memiliki beberapa pilihan untuk menentukan tempat sebuah operasi dijalankan.
Inference engine dapat membantu mengatur eksekusi model agar kemampuan CPU, GPU, maupun NPU dimanfaatkan secara efisien. Sebagian operasi dapat memperoleh efisiensi lebih baik melalui NPU, sementara pekerjaan lainnya mungkin lebih cocok menggunakan GPU maupun CPU. Pengelolaan yang tepat memungkinkan teknologi AI menggunakan accelerator sambil mengurangi overhead dan perpindahan informasi yang berlebihan.

Model AI Perlu Dioptimalkan agar Sesuai dengan Hardware
Quantization menjadi salah satu teknik yang dapat membantu mengurangi kebutuhan sumber daya ketika menjalankan model. Pendekatan ini menggunakan representasi angka dengan presisi yang lebih rendah untuk membantu menekan penggunaan memori dan beban pemrosesan. Untuk on device AI, efisiensi tersebut menjadi penting karena kapasitas memori, bandwidth, serta komputasi memiliki batas lebih ketat daripada pusat data.
Penerapan quantization perlu dievaluasi sebab penggunaan presisi yang terlalu rendah dapat memberikan dampak terhadap kualitas hasil. Tim pengembang harus menyeimbangkan kapasitas model, waktu pemrosesan, kebutuhan RAM, efisiensi daya, serta mutu keluaran. Konfigurasi optimal dapat berbeda berdasarkan perangkat sehingga pengujian langsung pada hardware tujuan menjadi penting dalam teknologi AI.
Manajemen Memori dan Energi Menentukan Pengalaman AI Lokal
Kecepatan inference tidak hanya bergantung pada kemampuan prosesor melakukan operasi matematika. Sistem perlu memindahkan data serta parameter model menuju unit komputasi sehingga kecepatan memori dapat memberikan pengaruh terhadap waktu inference. Ketika transfer data menjadi hambatan, hardware accelerator berperforma tinggi belum tentu dapat digunakan secara maksimal.
Efisiensi energi juga menjadi bagian penting ketika AI dijalankan secara lokal. Pemrosesan AI dengan beban tinggi dalam waktu panjang dapat meningkatkan penggunaan daya dan panas. Dengan demikian, inference engine perlu mengelola pembagian tugas, pemakaian memori, pemilihan unit komputasi, dan eksekusi workload agar performa tetap seimbang dengan efisiensi. Keseimbangan tersebut menjadi semakin penting bagi teknologi AI yang diharapkan berjalan sepanjang hari pada perangkat pribadi.
AI Lokal Membuat Optimalisasi Inference Semakin Penting
Optimalisasi inference engine semakin dibutuhkan ketika kemampuan AI mulai dijalankan langsung pada ponsel, komputer, serta perangkat edge. Pendekatan tersebut dapat memberikan latensi lebih rendah, mengurangi kebutuhan komunikasi dengan server, serta memungkinkan beberapa kemampuan berjalan langsung di perangkat. Akan tetapi, batas baterai, RAM, bandwidth memori, panas, serta kapasitas pemrosesan membuat optimalisasi menjadi kebutuhan penting. Kombinasi CPU, GPU, NPU, teknik quantization, pengelolaan memori, serta inference engine diperlukan agar teknologi AI dapat menggunakan hardware secara efisien. Apabila peningkatan hardware serta software berlangsung seimbang, on device AI berpotensi menjadi lebih responsif, efisien, dan mampu menangani model yang semakin canggih. Anda dapat mengikuti perkembangan teknologi AI Inference Engine Optimization sekaligus berdiskusi mengenai fitur on device AI yang paling berguna untuk perangkat masa depan.